dbt-charts を触ってみた 〜 導入手順と所感、Lightdash とのすみ分け 〜

皆さんこんにちは。広告プロダクト本部プロダクト開発部でデータサイエンティストをしている三浦です。

データ変換のツールとして dbt を使う現場は、ここ数年でかなり増えてきました。TVer でも分析基盤で dbt を使っています。 その dbt を作っている dbt Labs から、最近 dbt Charts(PyPI パッケージ名 dbt-charts、CLI 名 dct)という新しいツールが出てきました。 ダッシュボードを GUI で作るのではなく、YAML で「コードとして」書いてしまうツールです。 dbt を日常的に使っているチームとしては、エコシステムに新しいツールが出てきたら、早めに実際に触って「自分たちの運用に効きそうか」を見極めておきたいところです。公式ドキュメントや dct docs は揃っているものの、日本語の実践記事はまだ少ないので、まずはダミーデータを使って自分で動かしてみることにしました。

先に結論だけ書いておくと、こういう整理になりました。

  • dbt Labs 公式の「ダッシュボード as コード」ツール
  • 自由に探索したいなら Lightdash、定義をコードで管理して自動生成・配布したいなら dbt Charts、というすみ分け
  • ただし pre-1.0 で動きが速いので、本番採用の判断は時期を見たい

この記事では、dbt Charts がどんなものか・導入手順・Lightdash とのすみ分け・触ってみて分かったことを、順番に書いていきます。

dbt Charts とは

dbt Charts は、ダッシュボードを YAML で宣言して、中で SQL を実行し、その結果をチャートとして静的ファイルに書き出すツールです。 「YAML でボードを定義 → 各データソースに SQL を投げる → チャートを描画 → HTML などに出力」という順序で動きます。

作っているのは dbt 本体と同じ dbt Labs です。GitHub の dbt-labs/dbt-charts(Apache-2.0)で開発されています*1。「サードパーティの実験ツール」ではなく、dbt 本家が BI/ダッシュボードをコードに寄せに来た、という位置づけです。

そして、かなり新しいツールでもあります。PyPI で確認できる最初の公開が 2026-08-28(v0.5.0)で、そこから 3 週間足らずで v0.8.0 まで一気に上がっています(この記事で触ったのは 2026-09-15 リリースの v0.8.0 です)。

つなげられるデータソースは幅広く、v0.8.0 で実際に受け付けられた種別は dbt_profile / postgres / snowflake / bigquery / redshift / mysql / trino / duckdb / sqlite / csv / json / parquet / http の 13 種類でした。 ちなみに README には Databricks / Spark も対応と書かれていますが、これは dbt_profile(dbt adapter)経由での対応で、type: databricks のように直接指定すると Unknown source type で弾かれました。 type: に書けるのは上の 13 種で、それ以外のウェアハウスは dbt_profile で profiles.yml の target を参照する形になります。 csv / json / parquet みたいなファイル系のソースは DuckDB で処理されるので、ローカルにファイルさえあれば追加の DB なしでそのまま動きます。

出力形式は svg / html / png / pdf / terminal / json / text / yaml / data の 9 種類で、デフォルトは svg です(v0.8.0 の dct render --format で確認)。 チャートは内部で Vega-Lite の spec に変換され、vl-convert がサーバ側で SVG にします。 そのため出力された HTML には、Vega-Lite や D3 のような JS ライブラリの参照が含まれていませんでした。

なお、まだ pre-1.0(今回は v0.8.0)なので、記法は今後変わる可能性が高そうです。実際、上に書いたとおり短い期間でどんどんバージョンが上がっています。

検証環境

先に今回の検証範囲を書いておきます。試したのは CSV / DuckDB のダミーデータと、bigquery ソースでの実データ接続まで(BigQuery は後半の章で触れます)。一方、dbt の dbt_profile ソースを介した dbt 連携そのものは、今回は検証していません。dbt を使う身としては一番気になる部分なので、次回あらためて試すつもりです。

検証データは DuckDB / CSV のダミー広告データです。 架空のスポンサー 8 キャンペーン × 365 日 × 4 デバイス(CTV / Mobile / PC / Tablet)の日次データにしました。列は date / campaign / device / impressions / completes / clicks の 6 つ、計 11,680 行です。数値はサンプル用に小さめで、実際の配信規模とは無関係です。

ダッシュボードが寂しくならないよう、季節性・キャンペーンの放映期間・週末の視聴増だけスクリプトで作り込んでいます。放映期間といってもオフシーズンの行を消しているわけではなく値を小さくしているだけなので、行数は全キャンペーン分そろって 11,680 で一定です。乱数は使っていないため、何度実行してもまったく同じ CSV になります。

# gen_data.py(抜粋)— すべて架空のスポンサー
CAMPAIGNS = [
    ("ソライロ生命「みらい応援」",     70_000, 0.87, 0.0050, "year"),
    ("ことのは温泉 夏の大旅行",         64_000, 0.80, 0.0058, "summer"),
    ("ホクホク製菓 冬のあまいギフト", 56_000, 0.86, 0.0055, "winter"),
    # ... 他5件(通年 / 夏 / 冬 / 新生活)
]
date,campaign,device,impressions,completes,clicks
2025-09-01,ソライロ生命「みらい応援」,CTV,40630,34768,204
2025-09-01,ソライロ生命「みらい応援」,Mobile,17957,15629,89
...

導入手順

実際に叩いたコマンドを、順番に載せていきます。

先に、今回作ったプロジェクトのディレクトリ構成を載せておきます。dbt_charts.yml をルートに置き、ボードの YAML は charts/boards/ に、データは data/ に置く、という構成にしました。これを頭に入れておくと、このあとのコマンドが追いやすいと思います。

dct-verify/
├── dbt_charts.yml          # プロジェクト設定(データソース・サーバ)
├── gen_data.py             # ダミーデータ生成スクリプト
├── data/
│   └── ad_daily.csv        # ダミーデータ(gen_data.py で生成)
└── charts/
    └── boards/
        └── ad-overview.yml # ボード定義(YAML)

まずインストールですが、今回は uv run --with で都度実行しました(pip install などでの常設インストールは試していません)。

# 検証で使った実行方法(ダミーCSVだけなら [bigquery] は不要)
uv run --with dbt-charts dct --help

次に、プロジェクト設定の dbt_charts.yml で、データソースとサーバのポートを宣言します。

server:
  port: 19410
sources:
  db:
    type: csv
    files:
      ad_daily: data/ad_daily.csv

ダミーデータを生成します。

python gen_data.py   # data/ad_daily.csv (11,680 rows) を生成

ボードを YAML で書きます。KPI・エリア・バーといったチャートを charts: に、画面の並びを rows: に書きます。

title: TVer広告 配信オーバービュー(ダミーデータ)
source: db
queries:
  totals:
    sql: SELECT SUM(impressions) AS total_impressions FROM ad_daily
  daily_imp:
    sql: |
      SELECT date::DATE AS date, SUM(impressions) AS impressions
      FROM ad_daily GROUP BY 1 ORDER BY 1
charts:
  kpi_imp:   { label: 総インプレッション, type: kpi,  query: totals,    value: total_impressions }
  imp_trend: { title: 日次インプレッション, type: area, query: daily_imp, x: date, y: impressions }
rows: [kpi_imp, imp_trend]

ここでは最小構成で載せましたが、実際に作ったボードは KPI(総 imp・完視聴率=動画を最後まで見た割合・CTR)+日次トレンド+キャンペーン別+デバイス別+月次 CTR を並べ、cols: で横並びも使っています。この記事のスクリーンショットはそちらのボードです。

書いたボードを検証します。dct validate はコンパイラがかなり厳格で、設定ミスをその場で弾いてくれました。

dct validate
# ✓ charts/boards/ad-overview.yml OK

たとえば KPI チャートのタイトルは label: で書く必要があり、うっかり title: と書くとこう落ちます(知らないキーを書いても同様にエラーです)。

╭──────────────────────────────────────────────────────────────────────────────────────────────────────╮
│ ERR-VALIDATION-FIELD  Field 'charts.kpi_imp.kpi': Value error, `title:` is not used on `type: kpi`.  │
│ Use `label:` instead.                                                                                │
│ At: charts/boards/ad-overview.yml:58                                                                 │
│ Docs: dct docs board                                                                                 │
╰──────────────────────────────────────────────────────────────────────────────────────────────────────╯

落ちた場所は At: にファイルと行番号で出ます(58 行目というのは、上の抜粋ではなく実際に作ったボードのほうです)。Docs: に調べ方まで添えてあるのも助かりました。 最初は戸惑いましたが、ミスに早く気づけるのは安心感があります。

ローカルサーバでプレビューします。

dct serve   # http://localhost:19410
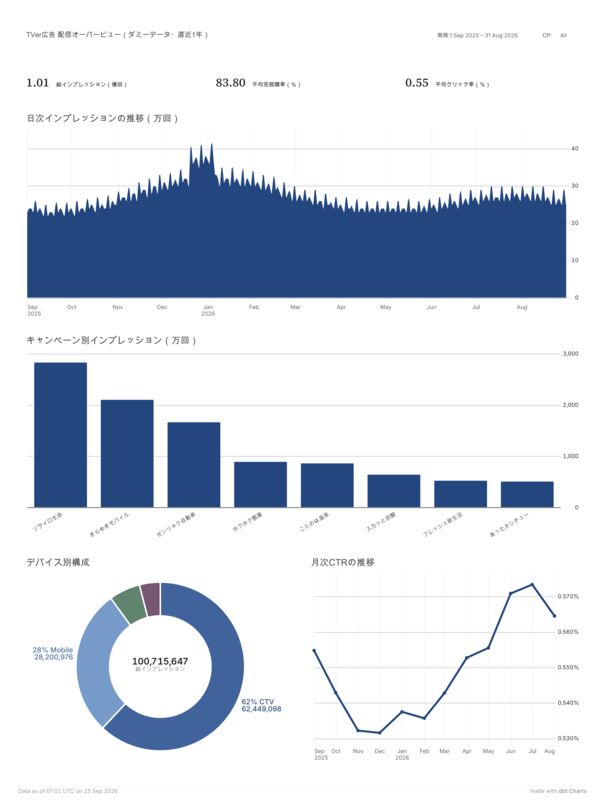
ダミーデータのダッシュボード全体
ダミーデータのダッシュボード全体

変数フィルタを使うと、期間やキャンペーンで絞り込めます。書き方は、variables: に入力ウィジェットを宣言して、SQL 側でマクロを呼ぶだけです。

variables:
  period:
    input: daterange
    label: 期間
    default: ["2025-09-01", "2026-08-31"]  # データ期間に合わせる
  campaign:
    input: multiselect
    label: CP                              # ラベルは短めに(理由は下記)
    column: ad_daily.campaign              # 列から選択肢を自動生成
-- 各クエリの WHERE でフィルタを効かせる
WHERE {{ filter('campaign', campaign) }}
  AND {{ filter_date_range('date', period) }}

ちなみにこの label: は最初「キャンペーン」にしていたのですが、ヘッダーの変数表示で文字がラベル枠からはみ出し、値と重なってしまいました(期間 は短いので問題なし)。日本語の長いラベルは幅の計算がうまくいかないようで、CP のように短くしたら直りました。

下は期間を 11〜1 月に絞った例です。KPI もチャートも、指定した期間の集計に切り替わります。
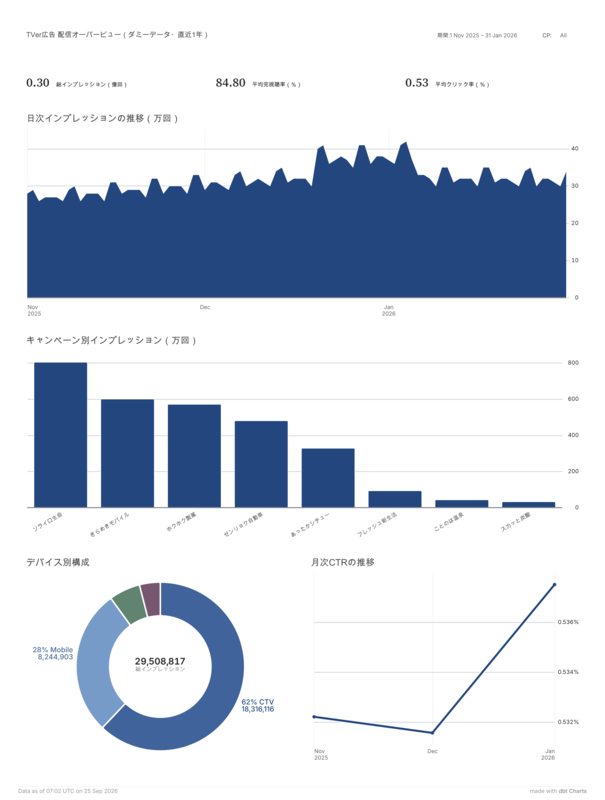
期間を絞ったダッシュボード
期間を絞ったダッシュボード

最後に、静的ファイルに書き出します。 ここで地味にハマったのが、render にはボード名ではなく ファイルパスを渡す点でした(ドキュメントには「board YAML へのパス」と明記されているのですが、つい名前を渡してしまいました)。 ボード名(ad-overview)を渡すと ERR-FILE-NOT-FOUND になり、charts/boards/ad-overview.yml とパスで渡したら通りました。

dct render charts/boards/ad-overview.yml --format html --output out.html

書き出した out.html はサーバなしで開ける単体ファイルです(見た目は上と同じボードです)。

BigQuery の実データにつなぐ

ここまではダミーの CSV / DuckDB でしたが、bigquery ソースで BigQuery 上の実データにもつないでみました。 dbt-charts[bigquery] を入れて、dbt_charts.yml のソースを bigquery にするだけです。今回実際に動いたのは、次のような設定でした(プロジェクト名などはマスクしています)。

sources:
  bq:
    type: bigquery
    project: <your-gcp-project>
    dataset: <your-dataset>
    location: asia-northeast1        # データセットのロケーション

認証は gcloud の application-default credentials(gcloud auth application-default login 済みの環境)でそのまま通り、今回は method: などのキーは指定していません。あとは [bigquery] 付きで起動すれば動きました。

uv run --with 'dbt-charts[bigquery]' dct serve

クエリを投げてボードをレンダリングするところまで問題なく動いたので、ダミーデータ専用のツールではなく、いま使っている DWH にそのまま向けられることは確認できた形です(実データのスクリーンショットは数値の都合で本記事には載せていません)。

Lightdash とのすみ分け

軸ごとに整理した比較表です。 dbt Charts 列はおおむね今回触って把握した内容、Lightdash 列は公開情報からの整理です*2(Lightdash は今回ハンズオンしていません)。

軸 dbt Charts (dct) Lightdash(公開情報)
位置づけ ダッシュボード as コード(YAML → 静的/live 出力) フル BI ツール(Web アプリ・セルフサーブ探索)
主な利用者 エンジニア/アナリストが書く前提 非エンジニア含む(GUI 探索)
定義の置き場 YAML をリポジトリ管理・PR レビュー可 dbt の metrics/dimensions + UI
インタラクティブ性 限定的(変数フィルタはあるが探索型ではない) 高い(ドリルダウン・自由探索)
出力 HTML/PDF/PNG/SVG/JSON/terminal ほか = 配布・埋め込み・自動化向き Web 共有・スケジュール配信
ホスティング 不要(CLI で render)。別途 Cloud もあり 要(self-host / Lightdash Cloud)
成熟度 pre-1.0(v0.8.0・記法が変わりうる) 成熟(OSS +商用)

所感

触ってみて「つまずいた」のは、このあたりでした。

  • デフォルトのフォントが大きめ(レポート寄り)。サイズは theme:(これは配色だけが変わる)では変わらず、style.title.level や KPI の variant、style.font.size で調整した。
  • daterange フィルタのデフォルトがデータのない期間だと、チャートが空っぽになった(デフォルトをデータ期間に合わせて回避した)。
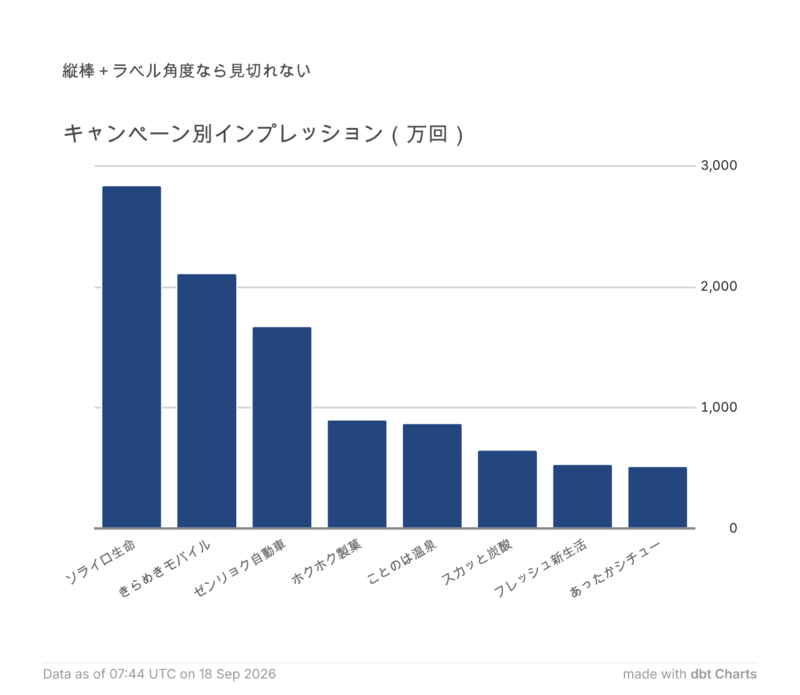
  • 横棒グラフだと日本語のキャンペーン名が見切れた。max_width も padding も効かず、結局 縦棒+ラベル角度 に変えて収めた。

見切れの話は絵にすると分かりやすいので、横棒(before)と縦棒+ラベル角度(after)を並べておきます。
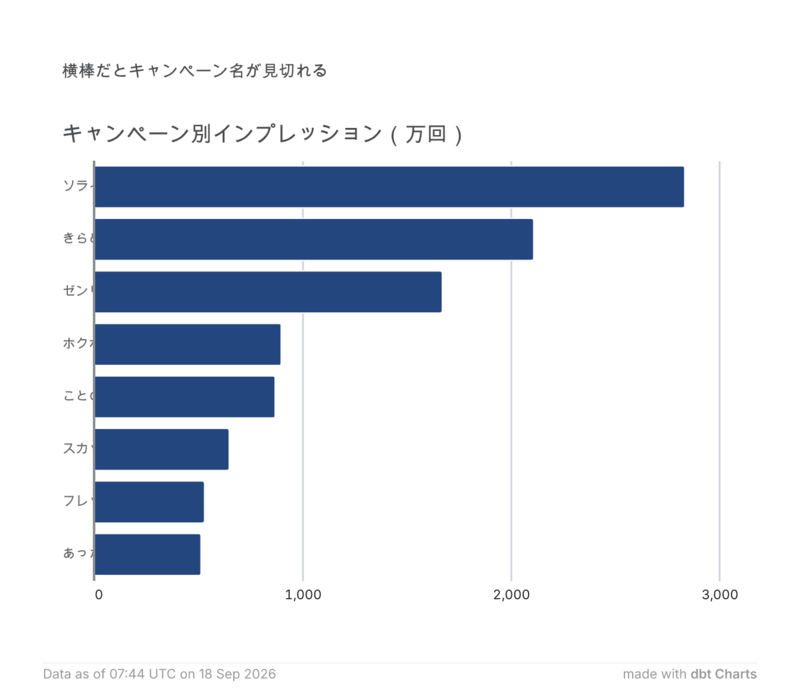
横棒だとキャンペーン名が見切れる
横棒だとキャンペーン名が見切れる(before)

縦棒とラベル角度なら見切れない
縦棒+ラベル角度なら見切れない(after)

逆に「これは良い」と感じたのは、render した HTML がサーバ不要の単体ファイルとして完結していて、そのまま配布や資料への埋め込みに使えたことです。

触ってみての実感としては、validate の厳しさやラベル調整のクセも含めて、「クリックで探る」より「仕様を読んで正しく書く」道具だと感じました。慣れれば速いものの、最初の学習コストはそれなりにあります。

まとめ

ざっくり整理すると、自由に探索してドリルダウンしたいなら Lightdash、定義をコードで管理して自動生成・配布したいなら dbt Charts、というすみ分けになりそうです。 dbt Charts は YAML と SQL でボードを宣言して CLI でファイルに書き出せるので、PR レビューや CI に載せやすいのが構造的な強みだと感じました。 一方で、探索的な操作が限定的な点は、採用するなら見込んでおく必要がありそうです。

自分たちの場合、最初に効きそうなのは営業向けの定型レポートです。 決まったフォーマットに指標をまとめる依頼が、同じ切り口で繰り返し発生するので、そのたびに手作業で組み直している部分を減らせそうです。 指標の定義が変わったときに PR の差分として残るのも、すでに dbt でモデルを管理している流れと地続きです。

正直なところ、まだ出たばかりで毎週のようにバージョンが上がっているツールなので、現時点で「使える/使えない」を言い切るのは早いと思っています。TVer のフェーズも見ながら、これからも動向を追って引き続き触っていくつもりです。進展があれば、また続きを書きます。

*1:PyPI のメタデータ上の作者は Fivetran, Inc. になっていますが、開発リポジトリは dbt Labs の dbt-labs/dbt-charts です(dbt Labs と Fivetran は統合済み)。バージョン・公開日は PyPI で確認: https://pypi.org/project/dbt-charts/

*2:Lightdash 公式サイト: https://www.lightdash.com/
DroidKaigi 2026 登壇レポート

はじめに

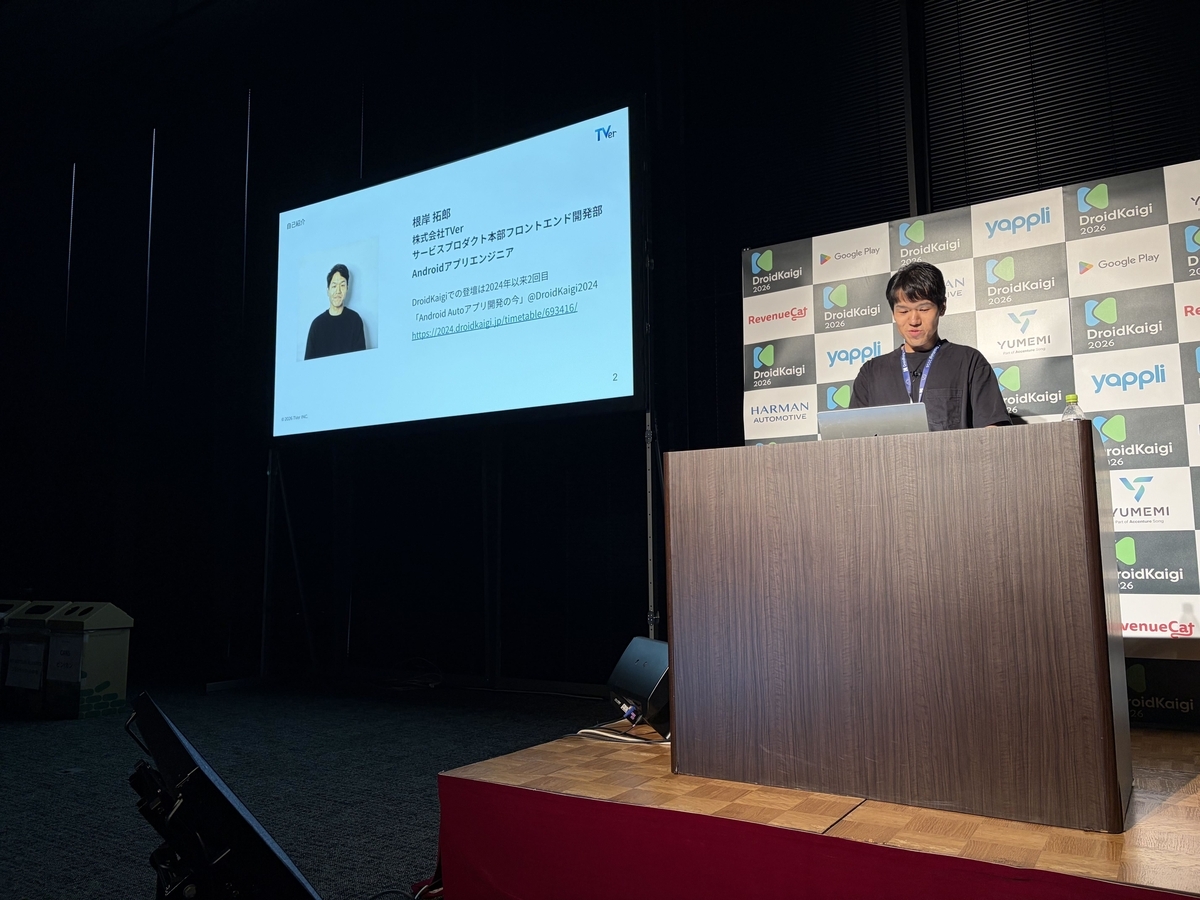
こんにちは、TVerのAndroidアプリエンジニアの根岸です。

TVerは今年、DroidKaigi 2026にサポーターとして協賛させていただきました。今回は私自身も登壇の機会をいただいたので、当日の会場の様子や自分のセッションの紹介、登壇した感想、聴講した他セッションについて紹介します。

techblog.tver.co.jp

DroidKaigiについて

DroidKaigiはエンジニアが主役のAndroidカンファレンスです。Android技術情報の共有とコミュニケーションを目的に、2026年9月1日(火)〜3日(木)の3日間、ベルサール渋谷ガーデンで開催されました。

会場の様子

登壇当日は多くの参加者で賑わっており、セッション会場だけでなく企業ブースやスポンサーラウンジでも活発な技術交流が行われていました。セッションごとに参加者の熱量の高さが伝わってきて、今年もJetpack ComposeやKotlin Multiplatform、AIエージェントを活用した開発ワークフローなど、幅広いトピックが盛り上がりを見せていたのが印象的でした。

登壇したセッションの紹介

「動画配信アプリでの Engage SDK 導入 — TVer Android が Play ストアにコンテンツを届けるまで」というタイトルで登壇させていただきました。

  • 日時:9月3日(木) 14:20〜15:00
  • Track:Meerkat

Googleが提供するEngage SDKを使うと、自社アプリのコンテンツをPlayストアのウィジェットやタブレットのエンターテインメントスペースなどに表示できます。本セッションでは、TVer AndroidアプリへEngage SDKを導入してリリースするまでの経験をもとに、設計・実装・申請・運用のそれぞれの工程で得られた気づきやハマったポイントを共有しました。

発表資料はこちらです。ぜひご覧ください。

speakerdeck.com

登壇した感想

「これからEngage SDKを触ってみたい」方から、「導入したものの運用フェーズで迷っている」という方まで、幅広い層の方に聴いていただけたのが嬉しかったです。セッション後のAsk the Speakerでも多くの方にお越しいただき、実装や運用面はもちろん、TVアプリへの展開の進め方や、どのような人員体制で開発を進めているかといった、より具体的な質問もいただきました。同じように複数プラットフォームでのEngage SDK展開と向き合っているエンジニアの方が多いことを実感しました。

準備には苦労した部分もありましたが、登壇を通じて自分たちの取り組みを整理し直す良い機会にもなりました。次回もまた挑戦したいと思います。

聴講した他セッションの紹介

聴講した中から、印象に残ったセッションを紹介します。

1. MediaPipe Face Landmarkerの精度限界にどう立ち向かうか — ランドマーク幾何学による補正の実践

2026.droidkaigi.jp

MediaPipeで検出した表情パラメータ(Blend Shape)を使ってアバターを描画するアプリの開発知見を紹介するセッションです。「頬をふくらませる」表情がAndroidだけ上手く検知できないなど、一部のパラメータで精度が出ない問題に対して、ランドマーク座標から幾何学的に補正するアプローチが紹介されていました。また、端末のスペックや発熱状態に応じて表情推定の反映回数を出し分けるといった工夫も語られており、リソース制約下でのUX設計の工夫として興味深く聴きました。

2. UI仕様を「見えるもの」にする 〜 Compose Screenshot Testing とギャラリーで支える、AIエージェント時代のAndroid UI開発 〜

2026.droidkaigi.jp

Compose Preview Screenshot Testingを軸に、AIエージェントによる実装が増えていく時代のUIレビュー効率化について紹介するセッションでした。PR上に差分画像を自動投稿する仕組みや、ローカルとCI(Docker)の生成環境を揃えてflakyテストを削減する工夫、300枚を超える参照画像をHTMLギャラリーとして集約する運用など、実践的な知見が満載でした。普段は目視で確認しがちなUI差分を仕組みとして支える発想が勉強になりました。Ask the Speakerでもお話しさせていただき、マスター仕様書の管理方法やFigmaとの連携方法について質問しました。

3. Jetpack Compose新API詳解:FlexBox, Grid, Styles, mediaQueryで作るアダプティブUI

2026.droidkaigi.jp

FlexBox・Grid・Styles・mediaQueryという4つの新しいJetpack Compose APIについて、設計思想と実践的な使い方を解説するセッションでした。画面サイズや入力形式(タッチ操作かどうかなど)といった端末状況を表す「Media State」という考え方が紹介されていました。また、画面サイズなどの条件に応じてレイアウトを切り替える仕組みであるmediaQueryについては、切り替えのブレークポイントをアプリ側でoverrideできる点も語られていました。

おわりに

登壇者としても参加者としても、多くの学びと刺激を得られたカンファレンスでした。今回得られた知見を活かして、より良いアプリ開発に取り組んでいきたいと思います。

TVerでは幅広い職種で積極採用中です!もしご興味をお持ちいただけましたら、ぜひTVer採用サイトもご覧ください!

TVerはDroidKaigi 2026にサポーターとして協賛します!

こんにちは、TVerでフロントエンド領域のエンジニアリングマネージャーをしている黒田です。 TVerは今年、DroidKaigi 2026にサポーターとして協賛させていただくことになりました!弊社エンジニアの登壇もありますので、ぜひご覧ください。

DroidKaigiとは

DroidKaigiはエンジニアが主役のAndroidカンファレンスです。Android技術情報の共有とコミュニケーションを目的に、2026年9月1日(火)〜3日(木)の3日間、ベルサール渋谷ガーデンで開催されます。

国内外のAndroidエンジニアが集まり、最新の技術トレンドや開発ノウハウ、実践的な知見を語り合う場として、毎年多くの参加者で賑わっています。Jetpack ComposeやKotlin Multiplatform、パフォーマンス最適化、アーキテクチャ設計など、Android開発に関する幅広いトピックのセッションが行われ、エンジニア同士の交流も活発です。

https://2026.droidkaigi.jp/

DroidKaigi 2026では、弊社から根岸が登壇します!

「動画配信アプリでの Engage SDK 導入 — TVer Android が Play ストアにコンテンツを届けるまで」

  • 日時:9月3日(木) 14:20〜15:00
  • Track:Meerkat
  • テーマ:開発ツール&サービス(日本語セッション)
  • 発表者:根岸(Takuro Negishi / Android Engineer)

Googleが提供するEngage SDKを使うと、自社アプリのコンテンツをPlayストアのウィジェットやタブレットのエンターテインメントスペースなどに表示できます。
本セッションでは、TVer AndroidアプリへEngage SDKを導入してリリースするまでの経験をもとに、設計・実装・申請・運用のそれぞれの工程で得られた気づきやハマったポイントを共有します。
「これからEngage SDKを触ってみたい」方はもちろん、「導入したものの運用フェーズで迷っている」という方にも学びのあるセッションを目指していますので、ぜひお越しください!

TVerの様子はHRブログでも発信しています

TVerは「テレビを開放して、もっとワクワクする未来を」というミッションのもと、テレビコンテンツの新しい楽しみ方を提供し続けています。大規模動画配信サービスならではの技術的な課題や、それらをどのように解決してきたかについても、今後も発信していきたいと思います。

TVerで働くメンバーの様子や社内の雰囲気については、HRブログ(note)でも発信しています。技術ブログとあわせて、ぜひご覧ください!

https://note.com/tver

DroidKaigi 2026でお会いできることを楽しみにしています!

AWS DevOps Agent にアラートの一次調査を任せられるか検証した

こんにちは。広告プロダクト本部プロダクト開発部の森です。

この記事では、AWS DevOps Agent というインシデント調査の AI エージェントを、過去の本番アラートを使ってチームの対応履歴と比較評価した取り組みを紹介します。結果として、検証した 5 件すべてで当時のチームメンバーと同じ結論に到達し、ハルシネーションも見られませんでした。

背景 — アラートの対応状況

広告プロダクト本部プロダクト開発部では、TVer 広告の配信システムの開発・運用を担っています。 このシステムは AWS と Google Cloud にまたがって稼働しており、監視には主に New Relic を使っています。異常を検知すると Slack のアラートチャンネルに通知が届き、チームの誰かがログや指標を調査して「対応する / 静観する」を判断しています。

この運用がどれくらいの負荷なのかを把握するため、まず 3 ヶ月分の本番アラートを全件調査しました。結果は次の通りです。

  • 3 ヶ月で数十件のアラート(Issue)が発生
  • 人の介入(実対応)が必要だったのは 1 割強
  • 残りは実質対応不要(調査のみで静観・自己回復・誤検知)
  • 特に定型的なノイズ 3 系統(バッチ死活監視の誤検知・動画の音量チェック・外部からのスキャン)だけで 6 割強 を占める

つまり、大半のアラートは調査までで完結し、静観と判断しています。この調査を AI エージェントに任せられれば、運用負荷を下げられる可能性があります。

一方で、本当に対応が必要な 1 割強を見逃されては困ります。「ノイズの一次調査を任せられるか」と「本物の異常で原因まで到達できるか」の両方を確かめる必要がありました。

AWS DevOps Agent とは

AWS DevOps Agent は、AWS が提供する運用調査の AI エージェントです(2026 年 3 月に GA)。

本記事に関わる主な機能は次の 3 つです。

  1. アラートなどを起点にしたインシデントの自動調査
  2. 過去のインシデント分析にもとづく予防のための改善提案
  3. チャット形式で運用の質問に答えるオンデマンドのタスク

docs.aws.amazon.com

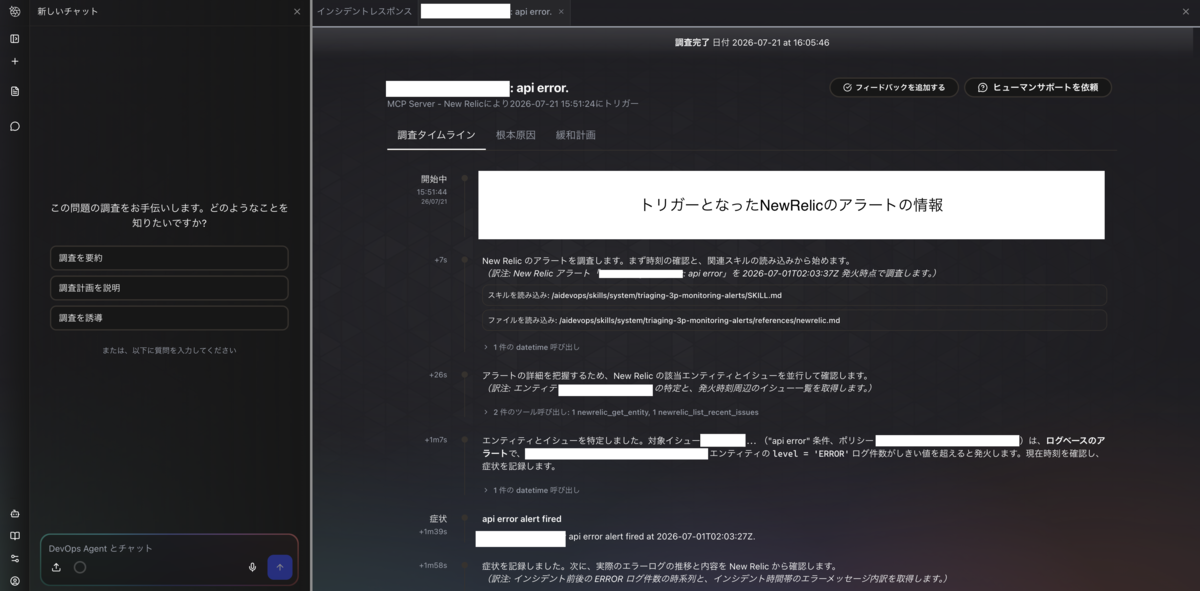
今回検証したのは 1 つ目のインシデント調査です。調査は、監視ツールからのアラート連携(Webhook)で自動起動するほか、Web Appからエージェントの調査結果を確認したり、チャットで問い合わせをしたりできます。

DevOps Agent Web App のスクリーンショット

エージェントは Agent Space という実行環境の単位で動きます。Agent Space は調査対象の AWS アカウントに紐づけて作成し、IAM ロールを割り当てると AWS リソースを調査できます。さらに設定で New Relic(API キーの登録)や GitHub(リポジトリの接続)を連携すると、AWS リソースの状態・監視データ・GitHub 上のコードを横断して調査できるようになります。

docs.aws.amazon.com

docs.aws.amazon.com

料金は $0.0083/エージェント秒(1 時間フル稼働で約 $30)の従量課金で、調査にかかった時間で費用が決まります。

Pricing – AWS DevOps Agent – AWS

安全設計 — 意図しない変更を防ぐ仕組み

本番環境に AI を接続するにあたり、意図しない変更が適用されないかを最初に確認しました。仕様と実際の動作の両方で確認しています。

  • 権限(IAM ロール)は読み取り専用。さらにガードレール(AWS 側が全セッションに強制する権限の上限)があり、ロール側で書き込み権限を付与してもエージェントは使えない
  • 設定やコードが自動で変更されることはない。修正は実施手順をまとめた緩和策プランとして提示され、適用は人間側の承認と操作で行う
  • 調査の全過程(思考・実行したクエリ・参照したデータ)がジャーナルとして記録され、後から監査できる

今回の検証でも、このジャーナルを使って AWS・New Relic・GitHub への全ツール呼び出しを機械検査し、書き込みがゼロであることを確認しています。

検証方法 — 対応履歴のある過去アラートで比較評価する

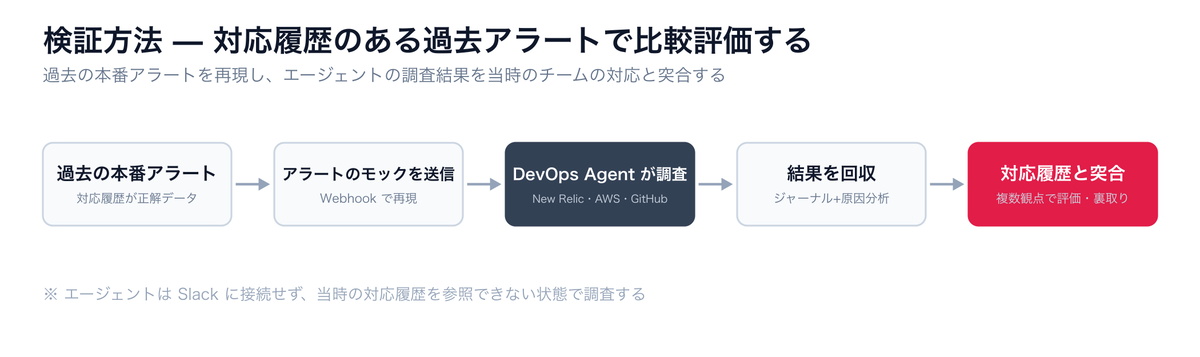
検証方式はシンプルです。過去の対応履歴のあるアラートをエージェントに調査させ、当時のチームメンバーの記録と比較して評価します。

  1. 過去の本番アラート(Slack に残るチームメンバーの調査記録=正解データ)を選ぶ
  2. 実アラートと同じ内容・発生時刻でアラートのモック(Webhook)を送信して調査を起動する
  3. エージェントが New Relic / AWS / GitHub を読んで調査する
  4. 調査結果(ジャーナルと原因分析)を回収する
  5. チームメンバーの記録と比較して評価する

検証の流れ

評価は複数の観点で行いました。指標・ログへの到達、コードの特定、状況評価(対応要否の判断)、クエリの提案、安全性、そしてハルシネーションチェック(事実に基づかない出力がないかの検証)です。

ハルシネーションチェックでは、エージェントの主張を調査とは独立した経路で裏取りしました。同じクエリを New Relic に投げ直す、GitHub API でコードの実在を確かめる、当時の Slack 記録と時系列を突合する、といった方法です。

なお、エージェントが当時の対応履歴を参照してしまうことを防ぐ対策も入れています。エージェントは Slack に接続しておらず、送信したアラートのモックにもチームメンバーの結論や Slack リンクは含めていません。

また、当時の対応はリアルタイムでしたが、エージェントの調査は数十日後に事後的に行ったものです。当時と同じテレメトリを遡って読ませてはいますが、厳密には同条件の比較ではありません。

検証環境

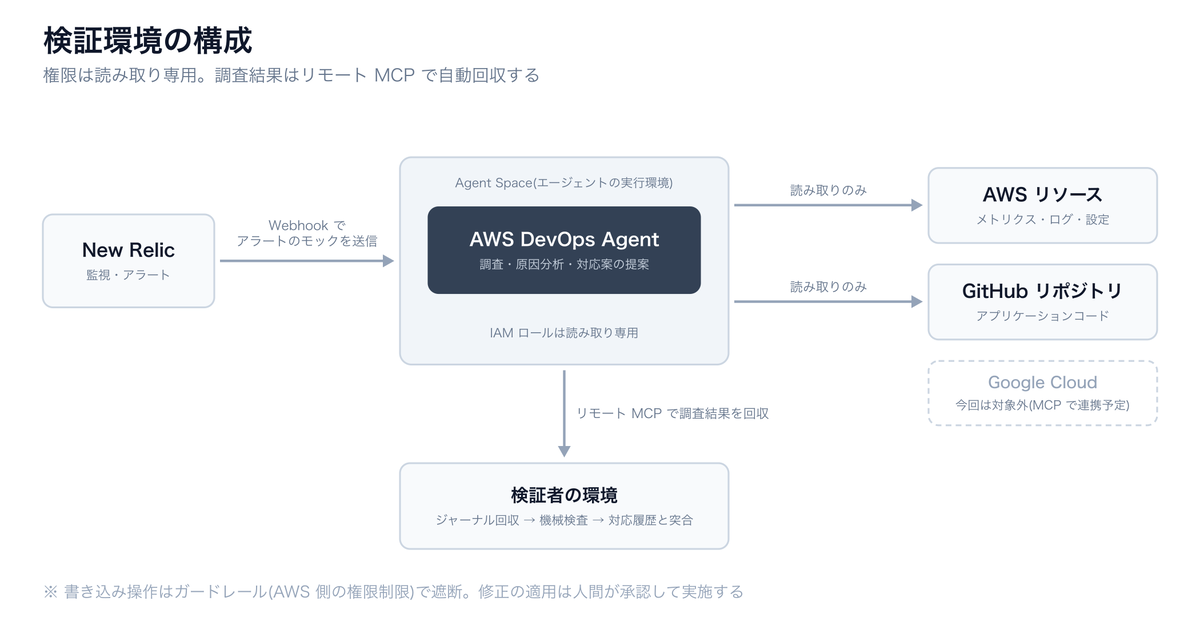
検証環境では、New Relic のアラート(今回はそのモック)を Webhook で Agent Space に送り、エージェントが AWS リソースと GitHub リポジトリを読み取り専用で調査する構成にしました。

検証環境の構成

なお、調査対象は Agent Space を作成した AWS アカウント内のリソースです。今回対象としたシステムは、調査に必要なリソースが AWS アカウント内に収まっているため、アカウントや Google Cloud をまたいだ調査は発生しません(Google Cloud 側の扱いは後述の未検証項目で触れます)。

結果の回収にはリモート MCP(Claude Code などの AI ツールから DevOps Agent に接続する仕組み)を使いました。アクセストークンの設定を含む回収の手順は、記事の後半「検証の進め方」で紹介します。

対象アラートの選び方

3 ヶ月の全アラートを「検知は正しかったか × 人はどう対応したか」で分類し、各分類の代表 5 件を選びました。

# アラートの種類 何を検知する? 当時の結末
事例 1 バッチの死活監視 日次バッチの実行メトリクスが一定時間届かないと発報 誤検知(メトリクス取り込み欠落)
事例 2 API のエラーログ監視 API のエラーログが一定件数を超えると発報 正検知・対応実施(バグ修正)
事例 3 重要バッチの実行エラー 配信データを連携するバッチのエラーを検知 正検知・自己回復(リトライ成功)
事例 4 API のエラーログ監視 事例 2 と同型。別サービスの API が対象 良性(外部スキャン)・監視側を調整
事例 5 動画の品質チェック 動画の音量が基準を外れると発報 正検知・対応不要(人が動画を確認)

「誤検知」「本物の異常」「実害のない良性検知」「人にしかできない確認が残るもの」という、性格の違う 4 分類をカバーする選定です。あわせて、背景で触れた定型的なノイズ 3 系統もこの 5 件に含まれています。

結果 — 5 件すべてで人間の結論と一致

先に結果をまとめます。

  • 状況評価(対応要否の判断)の一致: 5/5
  • ハルシネーション: 0 件(調査とは独立した経路での裏取りと、当時の記録との突合で確認)
  • 平均調査時間: 約 13 分

しかも今回の結果は、調査手順のカスタマイズ(SKILL.md)をしていない初期状態でのものです。ここからいくつか、印象的だった事例を紹介します。

事例 1: 誤検知であることを特定できた

日次バッチの死活監視アラートです。当時のチームメンバーは AWS コンソールでバッチの実行実績を確認し、「実際は動いており、メトリクスの取り込み欠落による誤検知」と判断して close しました。

エージェントも約 11 分で同じ結論(誤検知)に到達しました。結論までの過程では、CloudWatch のメトリクスからバッチが毎日エラーなく実行されていることを確かめたうえで、New Relic 側のアラート条件の設定内容や、メトリクスの取り込み経路が正常かどうかも確認しています。当時のチームメンバーと同じ調査過程が記録に残る形になっていました。

事例 2: バグの原因をコードレベルで特定した

API のエラー急増アラートです。当時はログから外部サービスの例外を特定し、DB を調べて特定の形式で登録されたデータが原因であると突き止め、データ修正とコードの恒久対応につなげた、3 ヶ月で最も「実対応」らしい事例でした。

エージェントは約 11 分で同じ結論に到達し、エラー件数まで当時の記録と一致しました。そのうえで、特定のフォームで入力値を正規化する処理が抜けていたことをコードレベルで特定しました。当時の記録は「恒久対応をチケット化」までだったので、修正箇所の具体性ではエージェントが上回りました。

印象的だったのは、DB の実データや実際の入力値について「調査の範囲外で確認できなかった」と自己申告したうえで、「根本原因の判定には影響しない」と整理したことです。確認できていれば何を切り分けられたかまで添えられていました。

事例 3: 「あえて直さない」という判断にたどり着いた

バッチからのファイルアップロード失敗を検知したクリティカルアラートです。実際にはバッチに組み込まれたリトライで回復し、処理全体は正常に完了していました。長期の運用で初めて発生した稀なエラーで、当時のチームメンバーはログで回復を確認し、原因を深掘りしたうえで「発生頻度を考えるとあえて直さない」と判断していました。

エージェントは約 12 分半で同じ結論(一過性・自己回復・対応不要)に到達しました。リトライが 11 秒後に成功したことをログの引用で裏付け、前後の実行分も含めて送信側のログに欠損がないことまで確認しています。エラーの発生箇所も、コードの行レベルまで特定していました。

一方で、限界も 2 点ありました。1 つは、欠損がないことの根拠が送信側(アプリ)のログである点です。アップロード先のストレージは AWS の外にあってエージェントからは見えず、エージェント自身も、この接続失敗の根本要因は特定できないと申告していました。もう 1 つは原因の深掘りで、当時のチームメンバーの方が一段深く、どの処理の段階で失敗したかまで特定していました。

事例 4: 良性の検知と判断し、監視クエリの調整案も一致した

外部からのスキャンが API のエラーを発生させた事例です。検知自体は正しいものの実害はない、いわゆる良性の検知で、当時は監視クエリを調整してノイズを抑える対応をしていました。

エージェントも良性と判断し、チームの実対応と同じ内容の監視クエリの調整案に到達しました。一方で、発見一覧にエージェント自身がツールの動作確認で作った項目が残るという軽微な表示上のノイズ(調査の結論への影響はなし)も見られました。また、「このアクセスは社内で実施中の取り組みによるもの」といった組織内の文脈までは把握できないことも確認できました。

事例 5: 人が確認すべき対象を特定した

動画の品質チェックのアラートです。最終的には人が動画を再生して確認する、人にしかできない対応が残るタイプです。

エージェントは再生こそできませんが、確認すべき対象を具体的に特定して提示しました。当時の記録に残っていなかった関連ジョブも拾っていました。最終判断は人に残るものの、「人が何を確認すべきか」まで絞り込めるという意味で、このタイプの代表例と言えます。

できないこと・まだ検証していないこと

今回の検証を通して分かった、エージェントにできないことと、検証のスコープ外とした項目をまとめます。

仕様上できないこと・人にしかできないこと:

  • RDS へ SQL を直接実行する権限はガードレールに含まれておらず、実行できない(今回はログとコードからの推論で代替できることを確認)
  • 動画の音量チェック(事例 5)のように、基準から外れたものの検知までは機械的にできても、それが実際に問題かどうかの最終判断は人が行う必要があるケースが残る。ただし、調査の過程で該当ファイルの保存先(S3 パス)を特定するなど、人の確認を補助する動きは可能

今回のスコープ外(未検証)のもの:

  • Slack 連携時の挙動(調査結果の通知やチャットでの対応)
  • Google Cloud 側を MCP サーバー連携で参照させた場合にどこまで調査できるか(Google マネージドの MCP サーバーが主要サービスで GA 済みで、読み取り権限のみで調査させる今回の方針とも合致する)
  • 本番アラートへの常時接続運用(今回は過去アラートの再現のみ)
  • 修正適用の自動化(外部のコーディングエージェントと連携する構成が公式ブログで紹介されているが、未検証)

コストと運用をどうするか

調査時間は 1 件あたり 11〜16 分(平均約 13 分)で、コストは 5 件の実測ベースの概算で $32.5(約 $6.5/件) でした。今回調査した 3 ヶ月分と同じアラート発生ペースを常時接続で処理すると、月あたり数十〜百ドル程度の規模感です。

金額としては大きくありませんが、全アラートに接続する必然性もないと感じています。重要度の高いアラートだけ有効化するなど、アラートレベルでの絞り込みが現実的というのが現時点の感触です。接続範囲や「常時かオンデマンドか」を含めた運用設計は、これから検討していきます。

検証の進め方 — Claude Code による効率化

最後に補足として、検証をどのように進めたかを手順に沿って紹介します。作業の多くは Claude Code で効率化しました。対応履歴の棚卸しや数百レコードの突合を、人手だけで行うのは現実的でないためです。

手順 1: 正解データを作る(Slack MCP で対応履歴を収集)

3 ヶ月分の対応履歴を、Claude の Slack 連携(MCP)を使い、読み取り専用の権限で収集し、全件を分類・記録化しました。記録項目は、発生日時・検知内容・当時の調査手順・結論(対応の要否)です。

収集の手順書を先に固めてから実行したのがポイントです。書き込みをしないことや集計の定義をレビューしてから走らせることで、後から再実行・再検証できる状態になりました。

手順 2: 過去アラートを Webhook で再現する

Webhook の送信スクリプトは、公式ドキュメントにあるペイロード仕様の調査からスクリプト作成までを Claude Code で行いました。送信内容と応答の自動記録、認証情報の環境変数管理を組み込んでいます。

セットアップと送信では、次の 2 点に注意が必要です。

  • 送信用の Webhook は、Agent Space で New Relic を有効化したときに URL とキーが発行され、発行時にしか表示されないため、このタイミングで控えておく
  • 複数件をまとめて送る場合は、同時に実行できる調査数などの上限に注意する

手順 3: 調査結果を回収して検査する(リモート MCP)

DevOps Agent のリモート MCP を Claude Code に接続し、調査の完了確認からジャーナルの全件回収(5 件で合計数百レコード)までを自動化しました。回収用のアクセストークンは、AWS コンソール側で Agent Space のトークン発行を許可したうえで、Web App の設定画面から発行するという 2 段階の手順が必要です。詳細な発行手順と接続方法は、公式ドキュメントを参照してください。

ハルシネーションチェックの裏取り(検証方法の章で述べた内容)も、この回収したジャーナルを起点に行っています。

手順 4: 評価してレポートにまとめる

評価の観点は前半の検証方法の章で挙げたものをそのまま使い、1 件ずつ評価レポートを作ってから統合レポートにまとめました。Markdown で作成し、同じ内容の HTML 版もあわせて生成することで、レビューをしやすくしました。

まとめ

  • 対応履歴のある過去アラートで比較評価する検証手法により、導入前に実データで性能を確認した
  • 実施した 5 件すべてで、対応要否の結論が当時のチームメンバーと一致し、ハルシネーションは見られなかった
  • ただし、文脈の理解が必要な判断や、ガードレールによる権限の制約で調査の深掘りができない場合もあった

今回の検証でアラートの一次調査を任せられる可能性が実データで確認できたので、引き続き、導入に向けて検証を進めます。 この記事が同じような運用課題を抱えているチームの参考になれば幸いです。

TVerはiOSDC Japan 2026にゴールドスポンサーとして協賛します!

こんにちは、TVerでiOS/Android領域のエンジニアリングマネージャーをしている黒田です。 TVerは今年も、iOSDC Japan 2026にゴールドスポンサーとして協賛させていただくことになりました!

iOSDC Japanとは

iOSDC Japan 2026はiOS関連技術をコアのテーマとした、ソフトウェア技術者のためのカンファレンスです。2026年は9月11日(金)〜13日(日)の3日間、有明セントラルタワーホール&カンファレンス、およびニコニコ生放送でのオンライン配信で開催されます。

国内外のiOSエンジニアが集まり、最新の技術トレンドや開発ノウハウ、実践的な知見を共有する場として、毎年多くの参加者で賑わっています。SwiftUI、各種デバイス対応、パフォーマンス最適化、アーキテクチャ設計など、iOS開発に関する幅広いトピックのセッションが行われ、エンジニア同士の交流も活発に行われます。

https://iosdc.jp/2026/

TVerのiOSエンジニア

TVerは民放公式のテレビ配信サービスとして、累計9,000万ダウンロード(2025年11月時点)を超える大規模なアプリケーションを運営しています。iOSチームではモダンな技術スタックを活用し、より良いユーザー体験を提供するための開発に日々取り組んでいます。

2025年12月には月間動画再生数が過去最高の6.5億回を記録し、MUB(月間ユニークブラウザ数)も4,470万(2026年1月時点)と、非常に多くのユーザーにご利用いただいているサービスです。安定性とパフォーマンスを重視しながら、継続的な改善と新機能の開発を進めています。

iOSDC Japan 2026での取り組み

iOSDC Japan 2026では、弊社からスポンサーセッションで登壇します!

「AI時代におけるiOS設計の守り方と人間の役割」

  • 日時:9月12日(土) 11:25〜11:45
  • Track:Track B
  • スポンサーセッション(20分)
  • 発表者:遠藤拓弥(@entaku_0818)

AIがコードを書く時代に、iOSエンジニアの役割はどう変わっていくのか。「AIが速く書くほど、設計が速く崩れる」という課題に向き合い、AIの出力を人間が監視し続けるのではなく、AIが正しく実装できるように設計そのものを整えるというアプローチに辿り着いた過程をお話しします。

あわせて、コーディングをAIに任せられるようになった先で人間が向き合うべき仕事——テストやリファクタリングといった品質にまつわる作業、優先順位の判断、要件の分解、共通ルールやドキュメントの整備、レビューの仕組み化、複数のAIエージェントの統率——についても、TVerのiOS開発における実践とうまくいかなかったことを含めて共有します。

TVerは「テレビを開放して、もっとワクワクする未来を」というミッションのもと、テレビコンテンツの新しい楽しみ方を提供し続けています。 大規模動画配信サービスならではの技術的な課題や、それらをどのように解決してきたかについても共有させていただく予定です。ぜひセッションにお越しください!

TVerの様子はHRブログでも発信しています

TVerで働くメンバーの様子や社内の雰囲気については、HRブログ(note)でも発信しています。技術ブログとあわせて、ぜひご覧ください!

https://note.com/tver

iOSDC Japan 2026でお会いできることを楽しみにしています!

#tver_iosdc2026

アクセシビリティ改善で意思伝達装置にも目を向けた話

こんにちは、TVerのサービスプロダクト本部でフロントエンドのEMをしている中谷です。

TVerでは、プロジェクトの開発進行とバランスを取りながら、アクセシビリティの向上に日々取り組んでいます。今回はユーザー様からいただいたお問い合わせをきっかけに、メーカー様のご協力を得て実機検証を行い、改善対応に繋げた事例について紹介させていただきます。

今回の対応について

意思伝達装置とは、ALSなどの難病で発話や身体操作が困難な方が、視線やスイッチといったわずかな動きで文字を入力しコミュニケーションを取ったり、PCなどを操作するための装置です。この装置を日常的に使っているユーザー様からお問い合わせをいただきました。

いただいた内容をもとに調査を進めたところ、TVer側の実装にいくつかのアクセシビリティ上の課題が見えてきました。

確認された課題と解決

課題は大きく二つありました。

1. ソフトウェアキーボードからの入力受付

TVer上でのキー入力ハンドリングが、ハードウェアキーボードのイベントのみを対象として実装されていました。そのため、意思伝達装置などで使われるソフトウェアキーボード経由の入力イベントが想定されておらず、反応しない状態になっていました。 原因は、入力判定に物理キーの位置を表す e.code のみを用いていた点にありました。ソフトウェアキーボードや支援技術では e.code が送られてこない場合があるため、e.code に加えて、入力された文字そのものを表す e.key でも判定するように修正し、解決しました。

2. プレイヤーメニューの操作性

動画プレイヤーにカーソルを合わせると再生・停止などの操作メニューが表示されますが、一定時間で自動的に非表示になる仕様でした。マウス操作であれば再度カーソルを動かせば済む挙動ですが、視線入力やスイッチ操作では、メニューが消えるまでに目的のボタンへたどり着くことが難しい状態となっていました。 こちらは、操作可能な要素(アイコン・ボタン)にホバーしている間はメニューを非表示にしないよう判定を加える形で、順次対応を進めています。

メーカー様のご協力と実機での検証

いただいたお問い合わせ内容から、コード上での問題の所在はすぐに把握できました。しかし、それが実際の操作においてどの程度の支障になっているのかは普段の開発環境ではなかなか実感しにくく、そこで今回意思伝達装置のメーカーである株式会社オレンジアーチ様に事情をご相談し、同社のeeyesをお借りすることができました。突然のご相談にもかかわらず検証の趣旨にご理解をいただき、快く実機をお貸しくださったことに、心より感謝しています。

eeyes

実際に実機をお借りし、ユーザーの方と同じ環境でTVerを操作してみると、私たちが普段当たり前に行っている操作感覚とはまるで違いました。実機に触れてその難しさを体感したことで課題の解像度が上がり、対応を進めることができました。

eeyesの操作画面

アクセシビリティ対応の学び

Webアプリケーションは、無意識のうちにマウスとキーボード操作を前提に最適化されがちです。内側だけを見ていては気づけない課題に、外からの声と実機に触れる機会を通じて光を当てていただけたことは、たいへん貴重な経験でした。 TVerのアクセシビリティ対応は、まだ道半ばです。今回の対応ですべてが解決したわけではなく、私たちが把握できていない課題や、行き届いていない点が数多く残っていると考えています。これからも、できるところから一つずつ改善を重ねていきます。

TVerで働くWebフロントエンドエンジニア募集中!

TVerをより使いやすく便利にしていくための様々な機能開発や改善を行うために、 TVerのミッション「テレビを開放して、もっとワクワクする未来を」に共感いただけるテレビの未来を支えるエンジニアの方をお待ちしております!

累計9,000万DLの民放公式テレビポータルのアプリ開発を担う、Webフロントエンジニアを募集!

最後までお読みいただきありがとうございました。

TVerにおけるテスト自動化の歩み

こんにちは。TVerのAutomationチームで、テストや開発業務の効率化・自動化を担当している城間です。

TVerの開発組織では、2025年からリリースサイクルの短縮に取り組み、リリーストレイン(複数チームが同期して決められたサイクルでリリースを行う運用)を導入しています。
いま現在、Web、iOS、Androidの各プラットフォームはおおむね隔週でのリリースを実現できており、その背景や経緯の詳細は弊社の「計測から始める品質とスピードの両立 - TVerの開発組織改革2年間の記録」で紹介しています。

techblog.tver.co.jp

リリースサイクルを短縮するためには、リリースのたびに行うリグレッションテストを短時間かつ確実に回せる仕組みが重要になります。

しかしながら、2025年の春先まで、TVerのリグレッションテストはすべて手動で行われていました。 リリースサイクルを短縮しようとすればするほど、テスト工数が線形に積み上がっていく構造で、これを解消しない限りリリーストレインの持続的な運用はできません。

リリーストレインの運用をはじめるにあたり、迅速かつ安定して検証ができる自動テスト基盤を構築することは、私たちAutomationチームの重大なミッションでした。

本稿では、私たちが約1年間、戦略策定から運用に至るまで、段階を踏んでテストの自動化を進めてきた過程とその取り組みを紹介したいと思います。

抱えていた課題

2025年の初頭、リリース前に実施していたリグレッションテストの所要工数は、概算で以下のとおりでした。

プラットフォーム リグレッションテストの所要工数
Web 約8.6人日
iOS 約4.9人日
Android 約5.1人日

これは、UIのリグレッションや、動画・ライブの目視確認、広告配信の検証など、複数のテストスイートにまたがる総工数の見積もりです。 継続的な機能改善とリリースを必要とするTVerサービスにおいて、毎回リリース前に数日分の検証工数を割き続ける運用には、いくつかの構造的な限界がありました。

  • テストの実行に一定の工数を要し、短サイクルでのリリース対応が困難
  • テスト実行の一部が属人化しており、チーム全体の生産性に波が出やすい
  • 人的ミスによる軽微な不具合の取りこぼしが発生しうる

また、TVerのテストには「動いて見える」だけでは検証できない領域があります。

ユーザーの操作の裏で送信されるTVerタグ(行動ログ)、視聴データの計測用ビーコン、広告に関連するURLパラメータ置換処理といったログ系の整合性確認です。
これらはTVerの主要KPI、ひいては放送局・広告主に対する説明責任に直結する重要な検証項目ですが、マニュアルではHTTPプロキシで通信ログを目視確認するしかなく、QAチームへの負荷も再現性も大きな課題でした。

戦略の策定から始める

私たちはテストの自動化を導入するにあたり、フレームワークの選定よりも前に、まずリグレッションテストの戦略を明文化することから始めました。
自動テストを持続可能なものにするためには、何を、どこまで、どのように自動化するのかを最初に定義しておく必要があります。

スコープの定義

戦略ドキュメントでは、テストピラミッドの考え方を参考に、リグレッションテストを正常系のユーザーシナリオに絞ることに決めました。
細かな分岐や例外は単体・結合テストに任せ、リグレッションテストでは主要導線がend-to-endで機能していること、ユーザー操作によって生じるCRUD処理(作成・読み取り・更新・削除)が正しく動くことを確認する。ピラミッドの頂点に置くべき範囲に限定する、という方針です。

加えて、前述したログ系の整合性確認も、主要KPIへの影響度が高いことからリグレッションテストのスコープに含めました。
ユーザー操作の裏で送信されるログまで含めて回帰を担保する、TVerのサービス特性を反映した判断です。

実行契機の整理

次に自動テストを「いつ、どのトリガーで、何のために回すか」を整理しました。 いまは主に次の3つの実行契機で回しています。

# 実行契機 目的 トリガー
1 mainブランチの変更 マージした変更のデグレードを早く検知し、不具合を溜め込まない mainブランチへのpush
2 リリース前検証 リリースコードの品質を確認し、リリース可否の判断材料とする releaseブランチへのpush
3 テスト環境のデイリーチェック 見逃した不具合や環境・依存の変化による不具合を早期に検知する CI日次実行

自動テストを導入する目的は単一ではなく、同じテストアセットでも、走らせるタイミングを変えれば狙えるリスクが変わります。
この前提を最初に揃えることで、後から個別の運用設計をブレずに進められました。

E2Eテスト環境を独立して用意する

戦略の次に着手したのは、E2Eテスト専用の検証環境を各プラットフォームで揃えて用意することでした。

通常の開発環境やステージング環境を流用すると、開発作業や手動テストの副作用が自動テストの結果に影響してしまい、再現性が大きく損なわれます。 テストごとに「いまの環境はどんな状態か」を気にしないと結果を信頼できない状況は、自動化の前提を崩します。

私たちはWeb/iOS/AndroidのそれぞれのOSで、E2Eテスト専用の環境を共通で見るようにしました。実装方法はOSごとに異なりますが、テストが実行されるバックエンドは同じ独立した環境を指しています。

データの独立性とテストの再現性、この2つを早い段階で担保することが、後の運用フェーズで「テストを信じてリリース判断する」という文化を作るうえで重要でした。

E2Eテスト専用の検証環境

リグレッションテストそのものを見直す

戦略と環境が用意できた後、私たちは自動化の実装に進む前に、もうひとつ大きな工程を挟みました。 既存のリグレッションテスト自体の作り直しです。

既存のリグレッションテストは、長らく画面の要素単位で書かれていました。
たとえば「シリーズ名が表示されていること」「エピソード名が表示されていること」「制作局が表示されていること」「配信終了日時が表示されていること」のように、画面のパーツがひとつずつ列挙され、それぞれを確認していくテストです。

このスタイルは、確認漏れを防ぐという観点では一定の意味がありましたが、自動化を視野に入れると、以下のような問題が見えてきました。

  • テストの単位がユーザーの目的と乖離している:「要素Aの表示確認」「要素Bの表示確認」と並んでいても、それが何のユーザーシナリオを担保しているのかが不明瞭
  • 項目数が膨らみやすい:同じ画面の要素を画面ごとに繰り返し確認することになり、機械的な確認項目が無限に増えていく
  • 自動化したときの価値が見えにくい:1要素1アサーションのテストを大量に走らせても、ユーザー体験のリスクをどこまで担保できているかが定量化しにくい

そこで私たちは、リグレッションテストをユーザーシナリオに沿ったend-to-endのテストに書き直しました。
「ユーザーが何をしようとしていて、そのために画面をどう操作し、結果として何が起きるべきか」を一つのシナリオにまとめ、その流れの中で要素の表示や挙動を検証する形に変えていきました。

書き直しに合わせて、テストスイートそのものの最適化も同時に進めました。
検証デバイスの精査、テストファイルの命名規則の整理、テストデータの記述ルール化、不具合があっても次回対応となるケースの除外といった、自動化と独立しても価値のある手動テストの整理も、自動化準備と並行して進めました。

テストケースの書き直しと最適化による効果は2つありました。

  1. テストの意義そのものが明確になった:1つのテストケースが「ユーザーがこれを達成できる」という保証単位になり、優先度づけやスコープの取捨選択が判断しやすくなった
  2. 自動化との相性が大幅に上がった:E2Eテストフレームワークは、もともとユーザー操作を起点としたシナリオの記述に最適化されており、書き直し後のテストはほぼそのまま自動化のテンプレートに乗せられる形になった

「既存のテストをそのまま自動化する」のではなく、自動化を視野に入れてテストそのものを再設計する。 この順序が、その後の実装フェーズの速度と質を大きく押し上げました。

ツールの選定

自動化ツールには、大きく分けてコード型OSS(Playwright/Cypress/Seleniumなど)とローコードSaaS(Autify/MagicPod/mablなど)の2系統があります。 私たちは双方を比較したうえで、最終的にコード型OSS(Web: Playwright、iOS: XCUITest、Android: Espresso)を選定しました。

選定にあたって特に重視したのは、プロダクトの開発サイクルとの親和性とメンテナンス性です。

  • ランニングコストを抑えられる:実行回数やシナリオ数に制限がなく、追加コストなしでスケールできる
  • プロダクトの開発プロセスに乗せやすい:各プラットフォームの開発言語と同じ言語でテストを書ける。Page ObjectモデルやCI/CDへの組み込みも、エンジニアが普段使うワークフローに載せやすい
  • 柔軟性が高い:HTTPリクエストの傍受やフィクスチャの差し替えなど、TVer特有の検証要件にあわせて拡張できる

SaaSにはレコーディングによるテスト量産しやすさという強みがある一方、メンテナンス性や実行制限、ランニングコストの面で、私たちが向かいたい方向とはトレードオフが大きいと判断しました。

設計上の工夫

工夫① 「テストの安定性を最優先し、メンテナンスコストを最小限に抑える」

実装方針として最初に掲げたのが、この一文です。E2Eテストは作るより維持するほうがはるかにコストがかかるため、設計のすべての判断をこの軸で評価することにしました。具体的な設計は以下のとおりです。

Page Object Model

「画面」を1つのクラスに抽象化し、テストはそのメソッドを呼び出すだけにすることで、UI変更の影響範囲をクラス1つに閉じ込めます。 さらに、3つのOSでPage Objectのファイル名を揃えるルールを徹底しました。

Web:     e2e/pages/EpisodePage.ts
iOS:     TVerLibrary/UITests/PageObjects/EpisodePage.swift
Android: app/src/androidTest/.../e2e/pages/EpisodePage.kt

同じ「エピソード詳細画面」を扱うクラスは、どのOSでもEpisodePageという名前を持ちます。
これにより、新しいテストを書くエンジニアがどのOSでも同じ感覚で実装でき、レビュー時にも他OSとの比較がしやすくなりました。

画面遷移を戻り値の型で表現する

Page Objectのメソッドは、画面遷移を伴う場合に遷移先のPage Objectを返す設計にしています。 これによって、テストコードが「画面A → 画面B → 画面C」というユーザー操作の流れをそのまま読み下せるようになります。

// iOSのPage Object設計(一部抜粋)
struct SettingsPage: PageObject {
    let app: XCUIApplication

    init(app: XCUIApplication) throws {
        self.app = app
        try waitForPageToLoad()
    }

    func tapNotificationButton() throws -> NotificationPage {
        notificationButton.waitAndTap()
        return try NotificationPage(app: app)
    }

    private func waitForPageToLoad() throws {
        try settingsTitle.waitForExistenceOrThrow(timeout: 10)
    }
}

フェイルファストで余計な待機を消す

iOSではPage Objectのinit内で前提となる要素の待機を行い、見つからなかった場合はthrowsで即座にテストを中断します。 途中の画面遷移に失敗したテストが、その後の操作で何度もタイムアウトを待つ、という典型的な無駄を排除する設計です。

sleepを書かない

固定のsleepはflakyの温床になるため、ヘルパー関数で待機を抽象化しています。
iOSではwaitAndTap() / waitAndType()、AndroidではwaitAndClickById() / waitAndClickByText()のような形で、すべての操作に「要素が利用可能になるまで待つ」処理を組み込んでいます。

工夫② APIでテストの冪等性を担保する

E2Eテストには、前回の実行が次の実行を壊す順序依存の問題がついて回ります。
「お気に入り登録できる」テストを2回連続で実行すれば、2回目は「すでに登録済み」状態となって挙動が変わってしまう、という類のものです。

私たちはテストごとに、必要な前提状態をAPIで直接揃えるアプローチを採用しています。

  • テスト前: 「あとで見る」をクリア、視聴履歴を消去、お気に入りを全削除する
  • テスト中: UIではなくAPIでテストデータを生成する(テスト観点に直接関係しない手順を省略)
  • テスト後: 状態をリセットして副作用を残さない

UI経由でこれらを行うよりも圧倒的に高速で、テストが何を前提にしているかがコードから明示的に読み取れるという副次的なメリットもあります。

同様の発想で、Feature flagのような実行時に変わりうる外部設定もテスト用の値に固定しています。
テスト中に配信内容が切り替わると結果がぶれるため、E2Eテスト側で取得処理を差し替えて外部依存を切り離し、再現性を保っています。

工夫③ テストを並列で動かして実行時間を抑える

E2Eテストはもともと実行コスト・メンテナンスコストの大きいテストです。ケース数が増えれば実行時間もメンテナンス負荷も膨らみ、開発のフィードバックループを遅くする要因になりかねません。
カバレッジの広さもテストにとっては重要ですが、それと引き換えにフィードバックの遅さを受け入れてしまうと、自動化の効果が損なわれていきます。

このトレードオフを抑えるために、複数のレイヤーで並列性を確保する設計にしています。

テストレベルの並列化 WebではPlaywrightの fullyParallel を有効化し、テストごとの独立性を前提に、複数ワーカーで同時実行しています。冪等性を担保したことが、そのまま並列実行の前提条件として効いています。

CIランナーレベルの分散実行 iOS/AndroidではCIワークフローのmatrixを使い、shard単位でテストを並列に分散実行しています。Androidではさらにphone/tabletのデバイス軸 × shard軸の二次元matrixを組んで、CI全体の所要時間を短縮しています。

実行環境の高速化 WebではAWS CodeBuildのカスタムランナーを採用し、CI実行時のリソース確保と起動時間の安定化を図っています。Playwrightブラウザのキャッシュも併用し、依存物のダウンロードコストを削減しています。

これらを組み合わせた結果、Webでは300をこえるテストケースが20分前後で完走できるところまで高速化できました。 リリース前検証も、main/releaseブランチへのpush起点のCIも、開発者の手を止めない時間内に収まる現実的なフィードバックループとして機能しています。 速度改善は単独の工夫ではなく、冪等性の担保や環境分離といった設計判断の上に積み上がっているものでもあります。

約350件のテストが18分で完走しています

工夫④ ログそのものをE2Eテストで検証する

冒頭で述べたとおり、TVerのテストには「画面が表示された」だけでは不十分な領域があります。 ユーザーの操作の裏で送信されるログの整合性確認は、サービスの根幹に直結する検証項目です。

これらは画面操作の自動化だけでは検証できません。WebではPlaywrightのpage.on('request')、iOS/AndroidではHTTPAssertionライブラリでHTTPレイヤを傍受し、期待のログが期待のパラメータで送信されたかまでを確認しています。

たとえば計測用ビーコンでは、ログイン状態やプライバシー設定の組み合わせごとに、再生時に送るパラメータが異なるため、検証パターンが必然的に多くなります。
サービス根幹に関わる領域なので確実に見たい一方、マニュアルでは網羅しにくい組み合わせですが、テストの自動化を進めることによって網羅的な検証が可能になりました。
「動画を再生したらビーコンが飛んだ」で終わらず、そのときのプライバシー設定が正しくフラグに反映されているかまで踏み込んで検証する。組み合わせ網羅が必須でありながら手動では担保しにくい領域を、率先して自動テストに置き換えていきました。

工夫⑤ AllureレポートでFail調査のリードタイムを縮める

CIでE2Eを回し始めると、すぐに直面するのが「失敗したテストの原因が、ログだけでは追えない」問題です。 Stack Traceは得られても、どの画面で、何が表示されていて、どのHTTPリクエストが飛んでいたか、これらが分からない限り、実行結果の深掘りに時間がかかります。

そこで、Web/iOS/AndroidのすべてでAllure Reportを導入しました。

Web E2Eテストの実行結果レポート

各OSで生成されたAllureレポートはすべてS3にアップロードし、共通の独自ドメインから配信しています。
Slack通知には毎回レポートURLを貼っており、「落ちた → URLクリック → スクリーンショット・動画・通信ログを確認」という流れが1アクションで完結します。

工夫⑥ マルチブラウザ・マルチデバイスに、必要な分だけ対応する

TVerはWebで複数の主要ブラウザに対応し、iOS/Androidはスマートフォンとタブレットの両方をサポートしています。E2Eテストでこれらを全件 × 全環境で回すと実行時間が膨大になるため、テストの性質に応じて環境を絞る工夫をしています。

WebではPlaywrightのプロジェクト機能を使い、メインスイートはChromiumで、ブラウザ固有挙動が出やすいテストだけをFirefoxやEdgeに振り分けています。 Androidでもアノテーションで「タブレットでも実行するテスト」を明示する仕組みを用意し、CI側でデバイスごとに並列分散しています。

すべてのテストを全環境で走らせるのではなく、必要な検証を必要な環境にだけ届けるという設計判断を行いました。

TVer QA Suite:自動テストでの主な使い方

TVerでは、テスト用の内製ツールTVer QA Suiteを運用しています。 2025年末に公開したukitakaの記事では、Proxyを使ったログ収集と自動検証の仕組みを紹介しましたが、いまは横断的なツール群として実装され、機能拡張が続いています。

仕組みとしては、

  • アプリが叩く外部サーバのURLを、QA SuiteのProxy経由に書き換える
  • リクエスト/レスポンスをS3に記録する
  • 検証ルールをWebUIから登録できる

という構成ですが、自動テストの文脈で現在もっとも活用しているのは、広告サーバーのプロキシ機能です。
QA SuiteのProxyは、テストごとに配信される広告テンプレート(VMAP/VAST)を差し替えることができます。

通常、広告は本物の広告サーバーから配信されるため、テストのたびに広告内容が変わってしまい、E2Eでは再現性のある検証が困難です。QA Suiteを経由させることで、

  • 「このシナリオではCompanion広告を含むパターン」
  • 「このシナリオではVAST Wrapperを経由するパターン」
  • 「このシナリオでは広告なしのパターン」

といったように、再生中の広告挙動をテスト側から制御可能になります。
これにより、本物の広告配信では再現性を担保することが難しかったケースでも、E2Eテストでは同じ条件を繰り返し検証できるようになりました。

取り組みの結果

各プラットフォームの定量的な成果

テスト自動化による成果は、プラットフォームごとに以下の通りです。

プラットフォーム 初期工数 自動化後の工数 削減幅
Web 約8.6人日 3.0人日 約65%
iOS 約4.9人日 2.0人日 約59%
Android 約5.1人日 2.1人日 約59%

TVerという動画配信プラットフォームの性質上、動画再生やライブ配信、UI/UXの体感など、どうしても目視確認を残さざるをえない領域があり、すべてを自動化して実施工数をゼロにすることはできませんでした。

それでも、自動化可能な範囲においては、Web/iOS/Androidのいずれも、リリース前のリグレッションテストの工数を約59〜65%削減し、2〜3人日程度まで抑えられました。
3プラットフォーム合計では約18.6人日から約7.1人日(約62%削減)となり、リリースのたびに約11人日分の工数を他の業務に充てられるようになっています。

リグレッションテストの工数推移

組織全体への波及効果

自動テスト単体の成果だけでなく、組織全体の品質・スピード指標にも変化が出ました。2025年度を通じて、

  • インシデントの発生件数: 約7分の1に減少(昨年比 -86%)
  • リリース頻度: 約2倍に増加(昨年比 194%)

という結果につながっています。もちろんこれはAutomationチーム単独の成果ではなく、全プロダクトチームの取り組みの総体ですが、自動テストによる品質担保とリードタイム短縮の両面から、こうした全社的な改善に貢献できた手応えがあります。

特にリリース頻度の倍増は、冒頭で触れたリリーストレイン運用と表裏一体です。
リリーストレインで「決まった周期に必ずリリースする」運用を成立させるには、毎リリース前のリグレッションテストが短時間で確実に回せることが前提条件になります。
自動化の整備はリリーストレインを下支えするインフラそのものであり、リリースサイクル短縮の実現には欠かせない取り組みでした。

質的な変化

数値以上に大きかったのは、「自動化によって、QAチームの活動そのものが変わった」という質的な変化です。
これまでリリース前の手動検証に多くの工数を割いていましたが、その役割をE2Eテストが肩代わりするようになりました。
これによりQAチームは新規機能のテスト戦略やリスクベースの探索的テストに集中できるようになり、「同じ確認を繰り返す役割」から、「どこに品質リスクがあるかを見極め、よりよい検証戦略を設計する役割」へと変わりました。

これから

私たちが今期より取り組んでいることは、以下の方向性です。

  • CTV(Connected TV)への展開: Linux CTV、ATV/FTVなど、これまで自動化が及んでいなかった領域の自動テスト導入
  • マニュアルテスト工数のさらなる削減: 既存自動テストの安定運用とカバレッジ拡大
  • 業務効率化ツールの内製: 自動化・効率化のための社内ツールを継続的に作成

そして、特に注力しているのが、AIを活用した自動テスト運用です。
E2Eテストは一度導入したらそのまま自走するわけではなく、新たに追加された機能のテスト実装や、テストが落ちたときの一次切り分け、その後の修正対応に依然として人手のコストがかかります。私たちはこの領域をAIで軽減する取り組みを、2つの方向で試験運用しています。

1. Claude Codeによるテストの自動化

E2Eテストの実装には、Claude Codeを使ったAIによる自動テストの実装を検証しています。
自然言語で書かれたテストケースを受け取ったAIが、TVerのドメイン知識やテスト設計手法・技術の知識を持つQAエンジニアスキルと、Page ObjectやE2E環境での実行手順を押さえたE2E実装スキルを併用し、テストコードを実装します。
実装後はテストを実際に動かして動作を確認し、Failするようであれば原因を分析して修正、問題がなければ自動でPR作成まで行います。
自動テストの新規実装はAIに任せ、人間はレビューに集中できる状態を目指しています。

2. Claude Managed AgentによるE2E実行結果の自動切り分けと修正PR作成

また、実行結果の確認、修正などの運用面の自動化を目指して、Claude Platform上で動くAIエージェント、E2E Failure Analyzer & PR Fixerを構築しました。

AIによる実行結果分析と修正

SlackのE2E通知チャンネルを監視し、失敗通知を検知すると、GitHub Actionsのジョブログから失敗テストを特定し、直近のPR・コミット・関連Slackスレッドを横断的に調査して、根本原因を4種類(flaky / 環境問題 / 実装との乖離 / 本物のバグ)に分類します。
修正可能な内容であればDraft PRを自動作成し、元のSlackスレッドに調査結果とPRリンクを返信します。 「Slack通知を見る → 原因を切り分ける → 修正PRを作る」までを、人手を介さずに走らせる仕組みです。

いずれも試験運用フェーズですが、Agentic codingによる開発速度の高速化についていくためには、こうしたAI活用を進めていく必要があると考えています。

まとめ

本稿では、自動化を進めてきた過程と取り組みを紹介させていただきました。
振り返ると、まず戦略の策定・専用環境の整備・既存テストケースの見直しといった準備工程を先に整えてから実装に入ったことが、短期間での大きな工数削減とリリース頻度の改善につながったと感じています。

とはいえ、現状はまだ自動テストの運用を人間が支えているフェーズです。 次のステップとして、その運用までをAIに任せていく「自動テストの自動化」を目指していきます。

最後までお読みいただきありがとうございました。私たちと一緒に「品質と開発スピードを両立する開発組織」を作っていきたい方がいれば、ぜひ採用ページもご覧ください。