こんにちは。広告プロダクト本部プロダクト開発部の森です。
この記事では、AWS DevOps Agent というインシデント調査の AI エージェントを、過去の本番アラートを使ってチームの対応履歴と比較評価した取り組みを紹介します。結果として、検証した 5 件すべてで当時のチームメンバーと同じ結論に到達し、ハルシネーションも見られませんでした。
背景 — アラートの対応状況
広告プロダクト本部プロダクト開発部では、TVer 広告の配信システムの開発・運用を担っています。 このシステムは AWS と Google Cloud にまたがって稼働しており、監視には主に New Relic を使っています。異常を検知すると Slack のアラートチャンネルに通知が届き、チームの誰かがログや指標を調査して「対応する / 静観する」を判断しています。
この運用がどれくらいの負荷なのかを把握するため、まず 3 ヶ月分の本番アラートを全件調査しました。結果は次の通りです。
- 3 ヶ月で数十件のアラート(Issue)が発生
- 人の介入(実対応)が必要だったのは 1 割強
- 残りは実質対応不要(調査のみで静観・自己回復・誤検知)
- 特に定型的なノイズ 3 系統(バッチ死活監視の誤検知・動画の音量チェック・外部からのスキャン)だけで 6 割強 を占める
つまり、大半のアラートは調査までで完結し、静観と判断しています。この調査を AI エージェントに任せられれば、運用負荷を下げられる可能性があります。
一方で、本当に対応が必要な 1 割強を見逃されては困ります。「ノイズの一次調査を任せられるか」と「本物の異常で原因まで到達できるか」の両方を確かめる必要がありました。
AWS DevOps Agent とは
AWS DevOps Agent は、AWS が提供する運用調査の AI エージェントです(2026 年 3 月に GA)。
本記事に関わる主な機能は次の 3 つです。
- アラートなどを起点にしたインシデントの自動調査
- 過去のインシデント分析にもとづく予防のための改善提案
- チャット形式で運用の質問に答えるオンデマンドのタスク
今回検証したのは 1 つ目のインシデント調査です。調査は、監視ツールからのアラート連携(Webhook)で自動起動するほか、Web Appからエージェントの調査結果を確認したり、チャットで問い合わせをしたりできます。
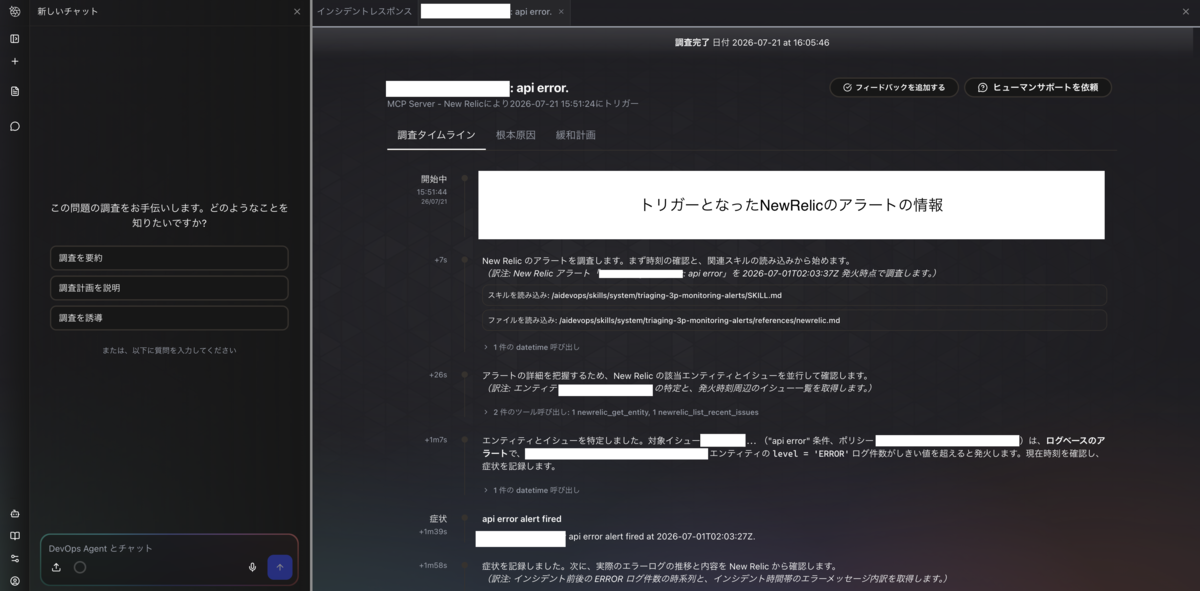
エージェントは Agent Space という実行環境の単位で動きます。Agent Space は調査対象の AWS アカウントに紐づけて作成し、IAM ロールを割り当てると AWS リソースを調査できます。さらに設定で New Relic(API キーの登録)や GitHub(リポジトリの接続)を連携すると、AWS リソースの状態・監視データ・GitHub 上のコードを横断して調査できるようになります。
料金は $0.0083/エージェント秒(1 時間フル稼働で約 $30)の従量課金で、調査にかかった時間で費用が決まります。
Pricing – AWS DevOps Agent – AWS
安全設計 — 意図しない変更を防ぐ仕組み
本番環境に AI を接続するにあたり、意図しない変更が適用されないかを最初に確認しました。仕様と実際の動作の両方で確認しています。
- 権限(IAM ロール)は読み取り専用。さらにガードレール(AWS 側が全セッションに強制する権限の上限)があり、ロール側で書き込み権限を付与してもエージェントは使えない
- 設定やコードが自動で変更されることはない。修正は実施手順をまとめた緩和策プランとして提示され、適用は人間側の承認と操作で行う
- 調査の全過程(思考・実行したクエリ・参照したデータ)がジャーナルとして記録され、後から監査できる
今回の検証でも、このジャーナルを使って AWS・New Relic・GitHub への全ツール呼び出しを機械検査し、書き込みがゼロであることを確認しています。
検証方法 — 対応履歴のある過去アラートで比較評価する
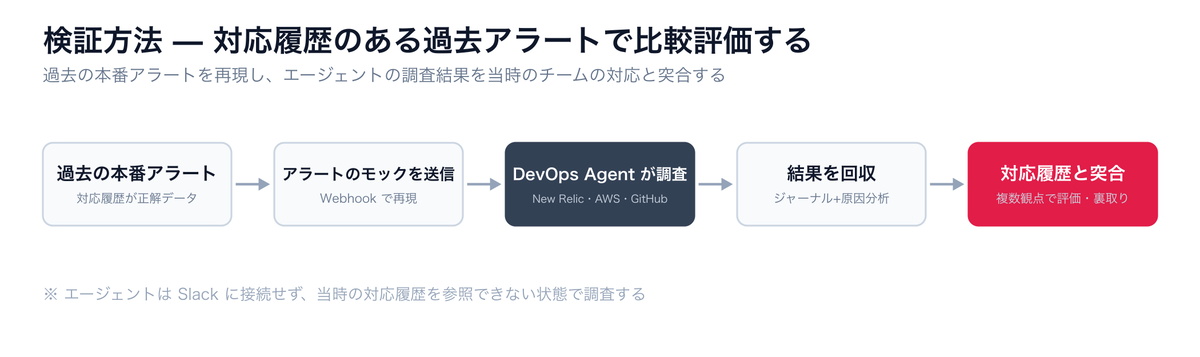
検証方式はシンプルです。過去の対応履歴のあるアラートをエージェントに調査させ、当時のチームメンバーの記録と比較して評価します。
- 過去の本番アラート(Slack に残るチームメンバーの調査記録=正解データ)を選ぶ
- 実アラートと同じ内容・発生時刻でアラートのモック(Webhook)を送信して調査を起動する
- エージェントが New Relic / AWS / GitHub を読んで調査する
- 調査結果(ジャーナルと原因分析)を回収する
- チームメンバーの記録と比較して評価する
評価は複数の観点で行いました。指標・ログへの到達、コードの特定、状況評価(対応要否の判断)、クエリの提案、安全性、そしてハルシネーションチェック(事実に基づかない出力がないかの検証)です。
ハルシネーションチェックでは、エージェントの主張を調査とは独立した経路で裏取りしました。同じクエリを New Relic に投げ直す、GitHub API でコードの実在を確かめる、当時の Slack 記録と時系列を突合する、といった方法です。
なお、エージェントが当時の対応履歴を参照してしまうことを防ぐ対策も入れています。エージェントは Slack に接続しておらず、送信したアラートのモックにもチームメンバーの結論や Slack リンクは含めていません。
また、当時の対応はリアルタイムでしたが、エージェントの調査は数十日後に事後的に行ったものです。当時と同じテレメトリを遡って読ませてはいますが、厳密には同条件の比較ではありません。
検証環境
検証環境では、New Relic のアラート(今回はそのモック)を Webhook で Agent Space に送り、エージェントが AWS リソースと GitHub リポジトリを読み取り専用で調査する構成にしました。
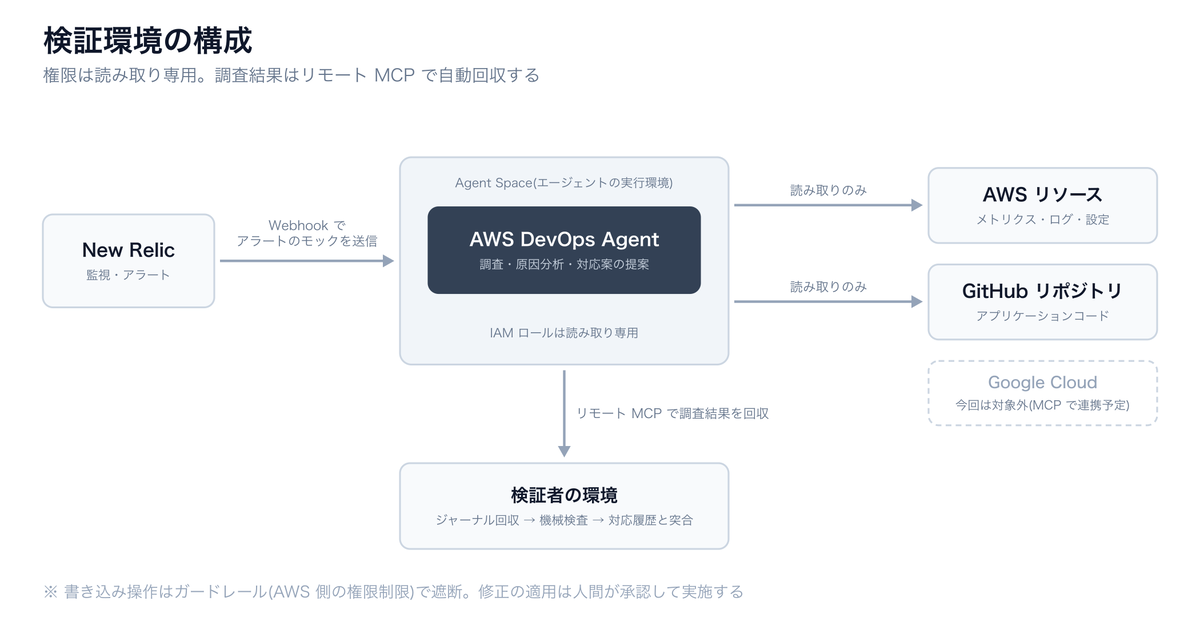
なお、調査対象は Agent Space を作成した AWS アカウント内のリソースです。今回対象としたシステムは、調査に必要なリソースが AWS アカウント内に収まっているため、アカウントや Google Cloud をまたいだ調査は発生しません(Google Cloud 側の扱いは後述の未検証項目で触れます)。
結果の回収にはリモート MCP(Claude Code などの AI ツールから DevOps Agent に接続する仕組み)を使いました。アクセストークンの設定を含む回収の手順は、記事の後半「検証の進め方」で紹介します。
対象アラートの選び方
3 ヶ月の全アラートを「検知は正しかったか × 人はどう対応したか」で分類し、各分類の代表 5 件を選びました。
| # | アラートの種類 | 何を検知する? | 当時の結末 |
|---|---|---|---|
| 事例 1 | バッチの死活監視 | 日次バッチの実行メトリクスが一定時間届かないと発報 | 誤検知(メトリクス取り込み欠落) |
| 事例 2 | API のエラーログ監視 | API のエラーログが一定件数を超えると発報 | 正検知・対応実施(バグ修正) |
| 事例 3 | 重要バッチの実行エラー | 配信データを連携するバッチのエラーを検知 | 正検知・自己回復(リトライ成功) |
| 事例 4 | API のエラーログ監視 | 事例 2 と同型。別サービスの API が対象 | 良性(外部スキャン)・監視側を調整 |
| 事例 5 | 動画の品質チェック | 動画の音量が基準を外れると発報 | 正検知・対応不要(人が動画を確認) |
「誤検知」「本物の異常」「実害のない良性検知」「人にしかできない確認が残るもの」という、性格の違う 4 分類をカバーする選定です。あわせて、背景で触れた定型的なノイズ 3 系統もこの 5 件に含まれています。
結果 — 5 件すべてで人間の結論と一致
先に結果をまとめます。
- 状況評価(対応要否の判断)の一致: 5/5
- ハルシネーション: 0 件(調査とは独立した経路での裏取りと、当時の記録との突合で確認)
- 平均調査時間: 約 13 分
しかも今回の結果は、調査手順のカスタマイズ(SKILL.md)をしていない初期状態でのものです。ここからいくつか、印象的だった事例を紹介します。
事例 1: 誤検知であることを特定できた
日次バッチの死活監視アラートです。当時のチームメンバーは AWS コンソールでバッチの実行実績を確認し、「実際は動いており、メトリクスの取り込み欠落による誤検知」と判断して close しました。
エージェントも約 11 分で同じ結論(誤検知)に到達しました。結論までの過程では、CloudWatch のメトリクスからバッチが毎日エラーなく実行されていることを確かめたうえで、New Relic 側のアラート条件の設定内容や、メトリクスの取り込み経路が正常かどうかも確認しています。当時のチームメンバーと同じ調査過程が記録に残る形になっていました。
事例 2: バグの原因をコードレベルで特定した
API のエラー急増アラートです。当時はログから外部サービスの例外を特定し、DB を調べて特定の形式で登録されたデータが原因であると突き止め、データ修正とコードの恒久対応につなげた、3 ヶ月で最も「実対応」らしい事例でした。
エージェントは約 11 分で同じ結論に到達し、エラー件数まで当時の記録と一致しました。そのうえで、特定のフォームで入力値を正規化する処理が抜けていたことをコードレベルで特定しました。当時の記録は「恒久対応をチケット化」までだったので、修正箇所の具体性ではエージェントが上回りました。
印象的だったのは、DB の実データや実際の入力値について「調査の範囲外で確認できなかった」と自己申告したうえで、「根本原因の判定には影響しない」と整理したことです。確認できていれば何を切り分けられたかまで添えられていました。
事例 3: 「あえて直さない」という判断にたどり着いた
バッチからのファイルアップロード失敗を検知したクリティカルアラートです。実際にはバッチに組み込まれたリトライで回復し、処理全体は正常に完了していました。長期の運用で初めて発生した稀なエラーで、当時のチームメンバーはログで回復を確認し、原因を深掘りしたうえで「発生頻度を考えるとあえて直さない」と判断していました。
エージェントは約 12 分半で同じ結論(一過性・自己回復・対応不要)に到達しました。リトライが 11 秒後に成功したことをログの引用で裏付け、前後の実行分も含めて送信側のログに欠損がないことまで確認しています。エラーの発生箇所も、コードの行レベルまで特定していました。
一方で、限界も 2 点ありました。1 つは、欠損がないことの根拠が送信側(アプリ)のログである点です。アップロード先のストレージは AWS の外にあってエージェントからは見えず、エージェント自身も、この接続失敗の根本要因は特定できないと申告していました。もう 1 つは原因の深掘りで、当時のチームメンバーの方が一段深く、どの処理の段階で失敗したかまで特定していました。
事例 4: 良性の検知と判断し、監視クエリの調整案も一致した
外部からのスキャンが API のエラーを発生させた事例です。検知自体は正しいものの実害はない、いわゆる良性の検知で、当時は監視クエリを調整してノイズを抑える対応をしていました。
エージェントも良性と判断し、チームの実対応と同じ内容の監視クエリの調整案に到達しました。一方で、発見一覧にエージェント自身がツールの動作確認で作った項目が残るという軽微な表示上のノイズ(調査の結論への影響はなし)も見られました。また、「このアクセスは社内で実施中の取り組みによるもの」といった組織内の文脈までは把握できないことも確認できました。
事例 5: 人が確認すべき対象を特定した
動画の品質チェックのアラートです。最終的には人が動画を再生して確認する、人にしかできない対応が残るタイプです。
エージェントは再生こそできませんが、確認すべき対象を具体的に特定して提示しました。当時の記録に残っていなかった関連ジョブも拾っていました。最終判断は人に残るものの、「人が何を確認すべきか」まで絞り込めるという意味で、このタイプの代表例と言えます。
できないこと・まだ検証していないこと
今回の検証を通して分かった、エージェントにできないことと、検証のスコープ外とした項目をまとめます。
仕様上できないこと・人にしかできないこと:
- RDS へ SQL を直接実行する権限はガードレールに含まれておらず、実行できない(今回はログとコードからの推論で代替できることを確認)
- 動画の音量チェック(事例 5)のように、基準から外れたものの検知までは機械的にできても、それが実際に問題かどうかの最終判断は人が行う必要があるケースが残る。ただし、調査の過程で該当ファイルの保存先(S3 パス)を特定するなど、人の確認を補助する動きは可能
今回のスコープ外(未検証)のもの:
- Slack 連携時の挙動(調査結果の通知やチャットでの対応)
- Google Cloud 側を MCP サーバー連携で参照させた場合にどこまで調査できるか(Google マネージドの MCP サーバーが主要サービスで GA 済みで、読み取り権限のみで調査させる今回の方針とも合致する)
- 本番アラートへの常時接続運用(今回は過去アラートの再現のみ)
- 修正適用の自動化(外部のコーディングエージェントと連携する構成が公式ブログで紹介されているが、未検証)
コストと運用をどうするか
調査時間は 1 件あたり 11〜16 分(平均約 13 分)で、コストは 5 件の実測ベースの概算で $32.5(約 $6.5/件) でした。今回調査した 3 ヶ月分と同じアラート発生ペースを常時接続で処理すると、月あたり数十〜百ドル程度の規模感です。
金額としては大きくありませんが、全アラートに接続する必然性もないと感じています。重要度の高いアラートだけ有効化するなど、アラートレベルでの絞り込みが現実的というのが現時点の感触です。接続範囲や「常時かオンデマンドか」を含めた運用設計は、これから検討していきます。
検証の進め方 — Claude Code による効率化
最後に補足として、検証をどのように進めたかを手順に沿って紹介します。作業の多くは Claude Code で効率化しました。対応履歴の棚卸しや数百レコードの突合を、人手だけで行うのは現実的でないためです。
手順 1: 正解データを作る(Slack MCP で対応履歴を収集)
3 ヶ月分の対応履歴を、Claude の Slack 連携(MCP)を使い、読み取り専用の権限で収集し、全件を分類・記録化しました。記録項目は、発生日時・検知内容・当時の調査手順・結論(対応の要否)です。
収集の手順書を先に固めてから実行したのがポイントです。書き込みをしないことや集計の定義をレビューしてから走らせることで、後から再実行・再検証できる状態になりました。
手順 2: 過去アラートを Webhook で再現する
Webhook の送信スクリプトは、公式ドキュメントにあるペイロード仕様の調査からスクリプト作成までを Claude Code で行いました。送信内容と応答の自動記録、認証情報の環境変数管理を組み込んでいます。
セットアップと送信では、次の 2 点に注意が必要です。
- 送信用の Webhook は、Agent Space で New Relic を有効化したときに URL とキーが発行され、発行時にしか表示されないため、このタイミングで控えておく
- 複数件をまとめて送る場合は、同時に実行できる調査数などの上限に注意する
手順 3: 調査結果を回収して検査する(リモート MCP)
DevOps Agent のリモート MCP を Claude Code に接続し、調査の完了確認からジャーナルの全件回収(5 件で合計数百レコード)までを自動化しました。回収用のアクセストークンは、AWS コンソール側で Agent Space のトークン発行を許可したうえで、Web App の設定画面から発行するという 2 段階の手順が必要です。詳細な発行手順と接続方法は、公式ドキュメントを参照してください。
ハルシネーションチェックの裏取り(検証方法の章で述べた内容)も、この回収したジャーナルを起点に行っています。
手順 4: 評価してレポートにまとめる
評価の観点は前半の検証方法の章で挙げたものをそのまま使い、1 件ずつ評価レポートを作ってから統合レポートにまとめました。Markdown で作成し、同じ内容の HTML 版もあわせて生成することで、レビューをしやすくしました。
まとめ
- 対応履歴のある過去アラートで比較評価する検証手法により、導入前に実データで性能を確認した
- 実施した 5 件すべてで、対応要否の結論が当時のチームメンバーと一致し、ハルシネーションは見られなかった
- ただし、文脈の理解が必要な判断や、ガードレールによる権限の制約で調査の深掘りができない場合もあった
今回の検証でアラートの一次調査を任せられる可能性が実データで確認できたので、引き続き、導入に向けて検証を進めます。 この記事が同じような運用課題を抱えているチームの参考になれば幸いです。
